
Топ локальных нейросетей в 2026 году: какие модели и программы запускать на своём ПК и сколько видеопамяти нужно


Есть проект? Напишите нам
Обсудим задачу и подберём оборудование
Локальные нейросети помогают разбирать документы, писать код, создавать изображения и расшифровывать записи на своём компьютере. Текстовый помощник может работать на процессоре, а для генерации видео нужно учитывать память всех компонентов схемы.
Разберём программы запуска и требования к памяти: как проверить, подходит ли локальная нейросеть на ПК для вашей задачи и когда обновлять систему. Рассматриваем инференс — работу уже обученных моделей, без обучения и дообучения. Данные актуальны на 8 ноября 2026 года.
Коротко: что выбрать под задачи и память компьютера
| Задача и доступные ресурсы | С чего начать | Программа | Главное ограничение |
|---|---|---|---|
| Простой текстовый помощник, процессор и 16 ГБ оперативной памяти (RAM) | Qwen3.5-4B, GGUF Q4_K_M | LM Studio | Скорость зависит от процессора |
| Текст, видеокарта (GPU) с 8–12 ГБ | Ministral 3 8B Instruct Q4_K_M или Qwen3.5-9B Q4_K_M | LM Studio, llama.cpp | Ориентиры относятся к тексту без визуальных компонентов |
| Рассуждения, GPU с 16 ГБ | gpt-oss-20b, MXFP4 GGUF | Совместимый LM Studio | Нужны запас под кэш и поддержка формата диалога |
| Документы и сложные запросы, GPU с 24–32 ГБ | Qwen3.6-27B, GGUF Q4_K_M | llama.cpp, совместимый интерфейс | Для длинного контекста потребуется больше памяти |
| Работа с репозиторием, GPU с 24–32 ГБ | Qwen3-Coder-30B-A3B-Instruct Q4_K_M | Совместимый движок и агент для работы с кодом | Нужны инструменты и доступ к проекту |
| Mac на Apple Silicon с 32 ГБ общей памяти | gpt-oss-20b, MXFP4 GGUF | LM Studio, llama.cpp/Metal | Память делят вычисления, macOS и приложения |
| Изображения | FLUX.2 [klein] 4B | ComfyUI | Память нужна всей схеме генерации |
| Расшифровка записи / озвучивание текста | Whisper large-v3-turbo / Qwen3-TTS 0.6B Base | whisper.cpp / qwen-tts | Русский текст нужно проверить на точность, озвучку — прослушать |
С чего начать: задачи, модели и программы запуска
Это ориентиры для подбора при одном запросе, а не измеренные минимумы. Условия запуска и размеры файлов приведены ниже.
Как мы составили топ и что считаем локальной нейросетью
Этот топ локальных нейросетей — редакционная подборка по документации и опубликованным тестам, без собственных сравнительных испытаний. При выборе учитывали доступность весов, качество на нужном языке, расход памяти и простоту запуска.
Модель — архитектура с обученными весами. GGUF — формат файла для их хранения. Движок выполняет вычисления, интерфейс управляет диалогом. Например, в LM Studio вы работаете с окном чата, а файл GGUF обрабатывает совместимый движок llama.cpp. На Hugging Face можно найти веса, сверить автора, версию и лицензию.
Лучшие локальные нейросети решают вашу задачу с приемлемым временем ожидания. Новая версия сама по себе этого не гарантирует, поэтому единого победителя у подборки нет.
Открытые веса можно скачать при соблюдении лицензии. Локальный инференс выполняется на своём устройстве, а для работы без интернета нужны все компоненты без сетевых зависимостей. Само окно чата на ПК ещё не означает локальные вычисления: проверьте, где выполняется запрос.
Топ текстовых моделей для ПК
Qwen3.5-4B и 9B, Qwen3.6-27B: от первого запуска до работы с документами
Qwen3.5-4B — компактная модель для коротких вопросов, черновиков и простого пересказа. Файл Qwen3.5-4B-Q4_K_M.gguf от lmstudio-community занимает 2,71 ГБ — удобно для первого запуска на процессоре. Если качество не устраивает, сравните с более крупным вариантом на тех же заданиях.
Файл модели Qwen3.5-9B в Q4_K_M занимает 5,63 ГБ. Обе версии принимают текст, изображения и видео, а выдают текст. Для анализа кадров нужны дополнительные компоненты и совместимый движок. В аппаратных таблицах ниже рассматриваем текстовый режим.
Квантование снижает точность хранения весов и обычно сокращает их размер. Q4_K_M относится к 4-битным форматам (4-bit), но использует смешанную точность. Поэтому размер файла нельзя получить простым умножением всех параметров на половину байта. Сжатие также может менять качество ответов.
Для сложных текстовых задач выбрана модель Qwen3.6-27B: 27 млрд параметров, переключаемые рассуждения и нативное контекстное окно 262 144 токена. Токен — единица обрабатываемого текста. На ПК доступную длину истории ограничивает память.
Качество русскоязычных ответов Qwen3.6-27B стоит проверить на собственных заданиях. Результаты тестирования модели с весами BF16 нельзя напрямую переносить на квантованную версию Q4_K_M. Для сравнения можно взять Qwen3.8-27B.
Для текста подойдёт Qwen3.6-27B-Q4_K_M.gguf от ggml-org размером 19,4 ГБ. Нужна совместимая версия llama.cpp или интерфейс с подходящим движком. Начальный ориентир — 24–32 ГБ видеопамяти, с отдельным расчётом для длинной истории.
Gemma 4 12B-it: мультимодальная альтернатива
Для чата выбираем google/gemma-4-12B-it — модель, обученную следовать инструкциям. Базовая gemma-4-12B без суффикса -it не заменяет её в готовом чате. Вариант 12B Unified принимает текст, изображения, аудио и видеокадры, выдавая текст. Заявленный контекст — до 256 тысяч токенов.
Gemma подходит для разбора материалов разных типов, если движок и интерфейс поддерживают нужный ввод. Для русского сравните качество на тех же документах и запросах, что используете с Qwen.
Для текста выбран gemma-4-12B-it-Q8_0.gguf от ggml-org, 12,7 ГБ. Консервативный ориентир — видеокарта с 24 ГБ видеопамяти. При скачивании укажите Q8_0 явно: автоматическая команда репозитория может предлагать другой файл.
gpt-oss-20b: рассуждения и работа с инструментами
У gpt-oss-20b от OpenAI 20,91 млрд параметров всего, из которых на токен активны 3,61 млрд. Это MoE, или смесь экспертов: на каждом шаге работает часть обученных блоков, но остальные тоже нужно хранить в памяти. Такая архитектура сокращает вычисления, а память под веса считают по общему числу параметров и точности их хранения.
Модель подходит для задач с рассуждениями и инструментами. Усилие рассуждений настраивается, контекст — 131 072 токена. Движок должен поддерживать MXFP4 и Harmony — формат диалога со служебными каналами.
Файл gpt-oss-20b-MXFP4.gguf от lmstudio-community занимает 12,1 ГБ. MXFP4 применяется к экспертным весам, у других частей своя точность. Ориентир OpenAI — около 16 ГБ памяти. На видеокарте этого класса запас под кэш и буферы ограничит длину истории. Разворачивание MXFP4 в BF16 увеличит требования.
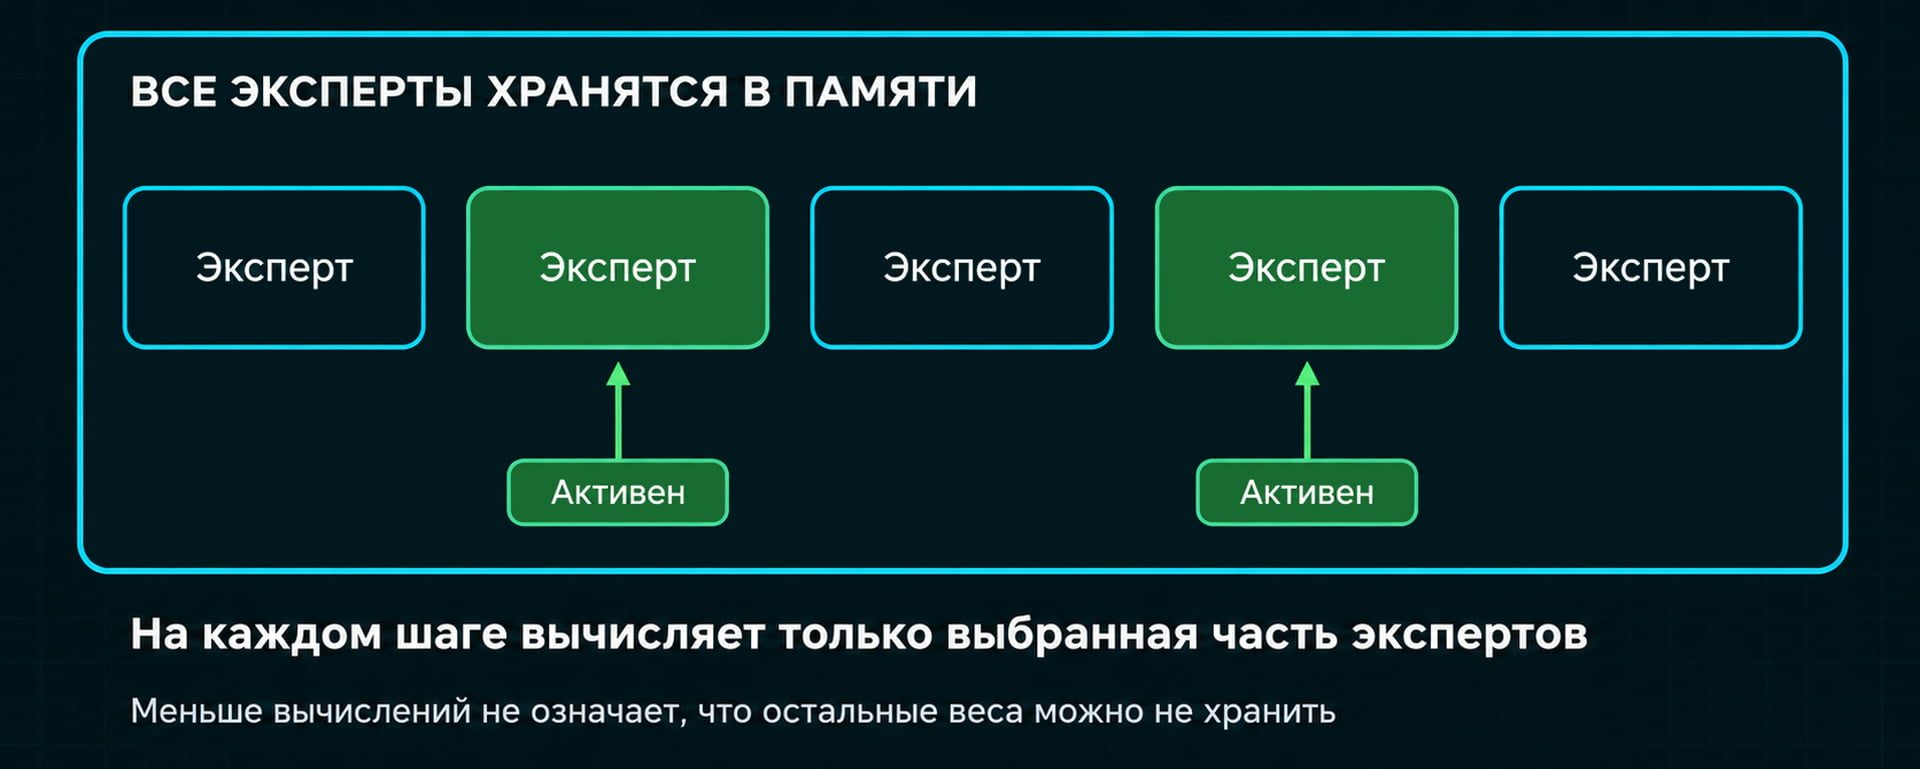
MoE сокращает вычисления, но хранить нужно весь набор весов
DeepSeek и Kimi: доступные веса ещё не означают запуск на обычном ПК
У DeepSeek-V4.1-Flash основная архитектура насчитывает 552 млрд параметров, у Kimi K3 полный размер — 2,8 трлн. Это серверный масштаб: обычной видеокарты на 16–24 ГБ для полных весов недостаточно, даже с учётом MoE.
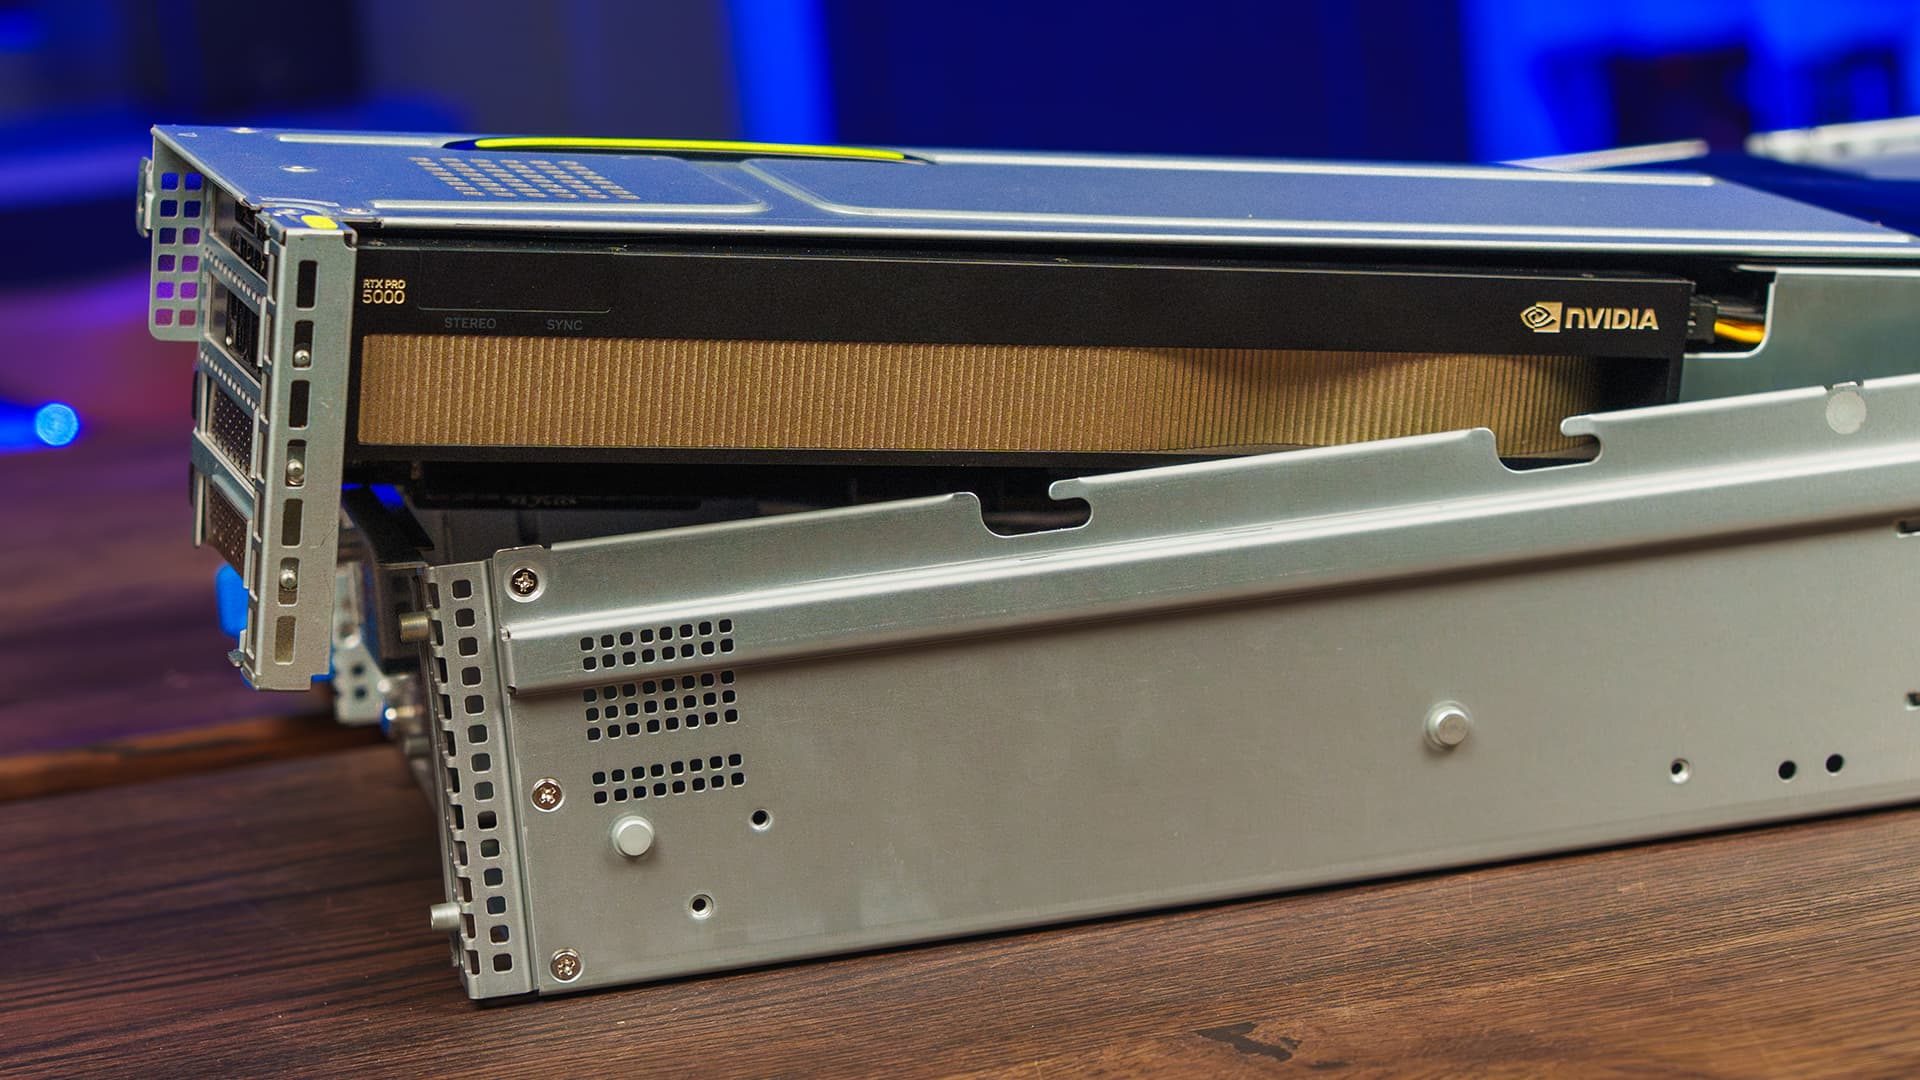
Профессиональная видеокарта RTX PRO 5000 в серверном корпусе
Дистиллированные выпуски — компактные версии, обученные с использованием результатов другого решения. Выбирайте их отдельно: имя DeepSeek не переносит на них возможности крупного исходника.
Ministral 3 8B Instruct и GLM-4.7-Flash: альтернативы под свою нагрузку
mistralai/Ministral-3-8B-Instruct-2512 — компактная модель Mistral с текстовым и визуальным вводом. У неё 8,4 млрд параметров языковой части и 0,4 млрд визуальной, контекст — до 256 тысяч токенов. Для чата выбран официальный GGUF Q4_K_M, 5,20 ГБ. Начальный ориентир для текста с умеренным контекстом — видеокарта с 8 ГБ видеопамяти.
На русском проверьте пересказ, имена, числа, соблюдение формата и редактирование. Общий перечень языков Mistral не показывает качество конкретного выпуска.
GLM-4.7-Flash — альтернативная MoE-модель с 30 млрд общих и примерно 3 млрд активных параметров. Сравните её с остальными на своей нагрузке, если выбранное ПО поддерживает GLM.
Локальные нейросети для программирования
Для объяснения функции достаточно чата. Для подсказок в редакторе важна малая задержка, а для изменения проекта нужен агент с доступом к файлам и инструментам. Поэтому результат в агентном тесте не говорит об удобстве автодополнения по ходу набора текста.
Qwen3-Coder-30B-A3B-Instruct: чат с кодом и агентная работа
У Qwen3-Coder-30B-A3B-Instruct 30,5 млрд параметров всего и 3,3 млрд активных. Выбранный GGUF Q4_K_M от lmstudio-community занимает 18,6 ГБ, начальный ориентир — 24–32 ГБ видеопамяти. A3B в названии обозначает активную часть, а не объём хранимых весов.
Это специализированная модель с нативным контекстом 262 144 токена и поддержкой вызова инструментов. Она работает без отдельного режима рассуждений. Для чата подключите совместимый локальный сервер к клиенту. Для агента проверьте обработку формата инструментов Qwen, доступ к репозиторию и запуск тестов.
В автодополнении проверьте задержку, учёт кода после курсора и формат запроса. Для частых подсказок компактный вариант может оказаться удобнее крупного агентного решения.
Devstral Small 2 24B: изменения в нескольких файлах
Модель Devstral-Small-2-24B-Instruct-2512 от Mistral работает с репозиторием и инструментами. У неё 24 млрд параметров, визуальный ввод и контекст до 256 тысяч токенов. Q4_K_M от lmstudio-community занимает 14,3 ГБ, ориентир для текстовой работы — 24–32 ГБ.
Сравните модели Devstral и Qwen3-Coder на одном проекте: с одинаковой задачей, доступом к файлам, числом попыток и тестами. Агентное окружение должно позволять найти нужный участок, применить правку и проверить результат.
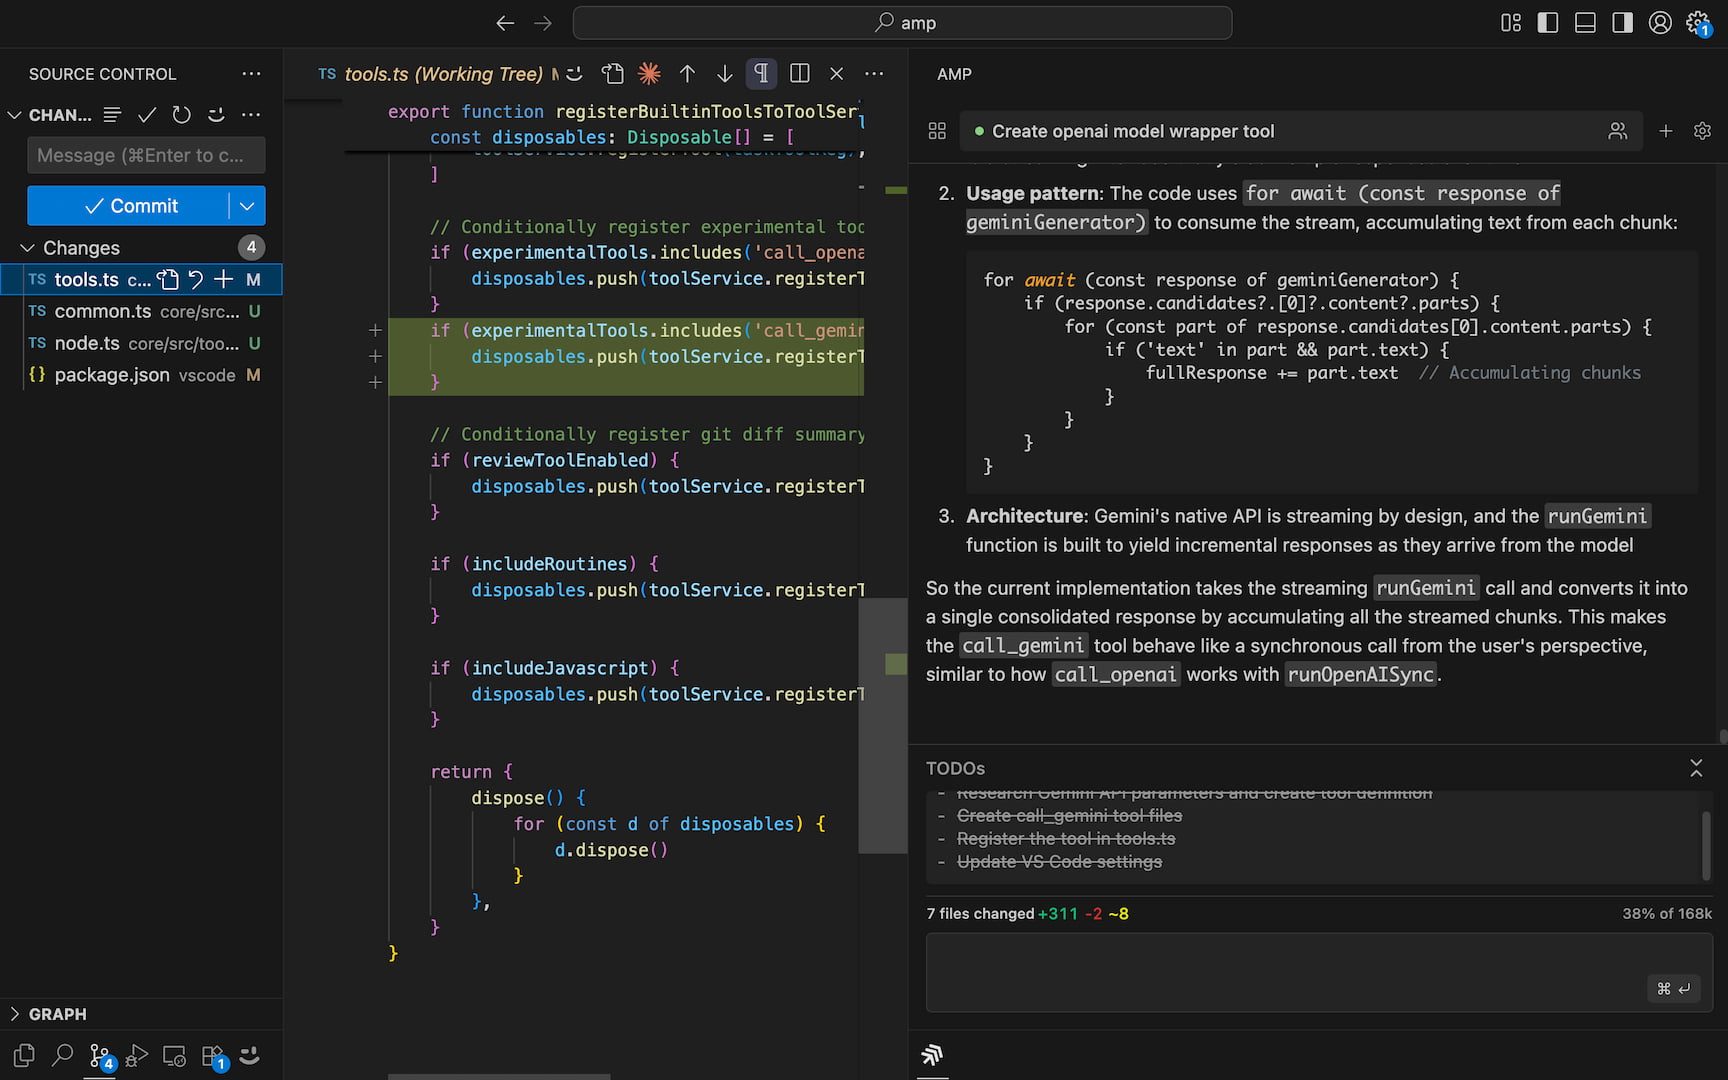
Агенту для работы с репозиторием нужны доступ к файлам, инструменты и проверка изменений
Подробнее о разделении чата, автодополнения и агента — в подборке локальных решений для программирования.
Нейросети для изображений и видео
Изображения: FLUX.2 [klein] 4B
Модель FLUX.2 [klein] 4B от Black Forest Labs подходит для генерации по тексту, редактирования и работы с несколькими референсами. Дистиллированный вариант использует четыре шага. В ComfyUI процесс собирают визуально, в Diffusers — программно.
Видеопамять нужна и компонентам, которые кодируют запрос и превращают внутреннее представление в изображение. На расход влияют разрешение, референсы, квантование и offload — перенос части данных между GPU и RAM. Экономия места на ускорителе может увеличить время генерации.
Разработчик приводит разные ориентиры: около 8 ГБ в репозитории FLUX.2 и около 13 ГБ в карточке 4B. Для подбора оборудования проверьте всю схему ComfyUI: эти цифры не задают единый минимум. Зафиксируйте запрос, разрешение, число шагов и референсов, затем меняйте по одному условию.
У 4B лицензия Apache 2.0, у FLUX.2 [klein] 9B — некоммерческие условия. Stable Diffusion 3.5 Medium остаётся альтернативой, если под него уже собран нужный процесс. Отлаженную схему необязательно менять ради более нового названия.
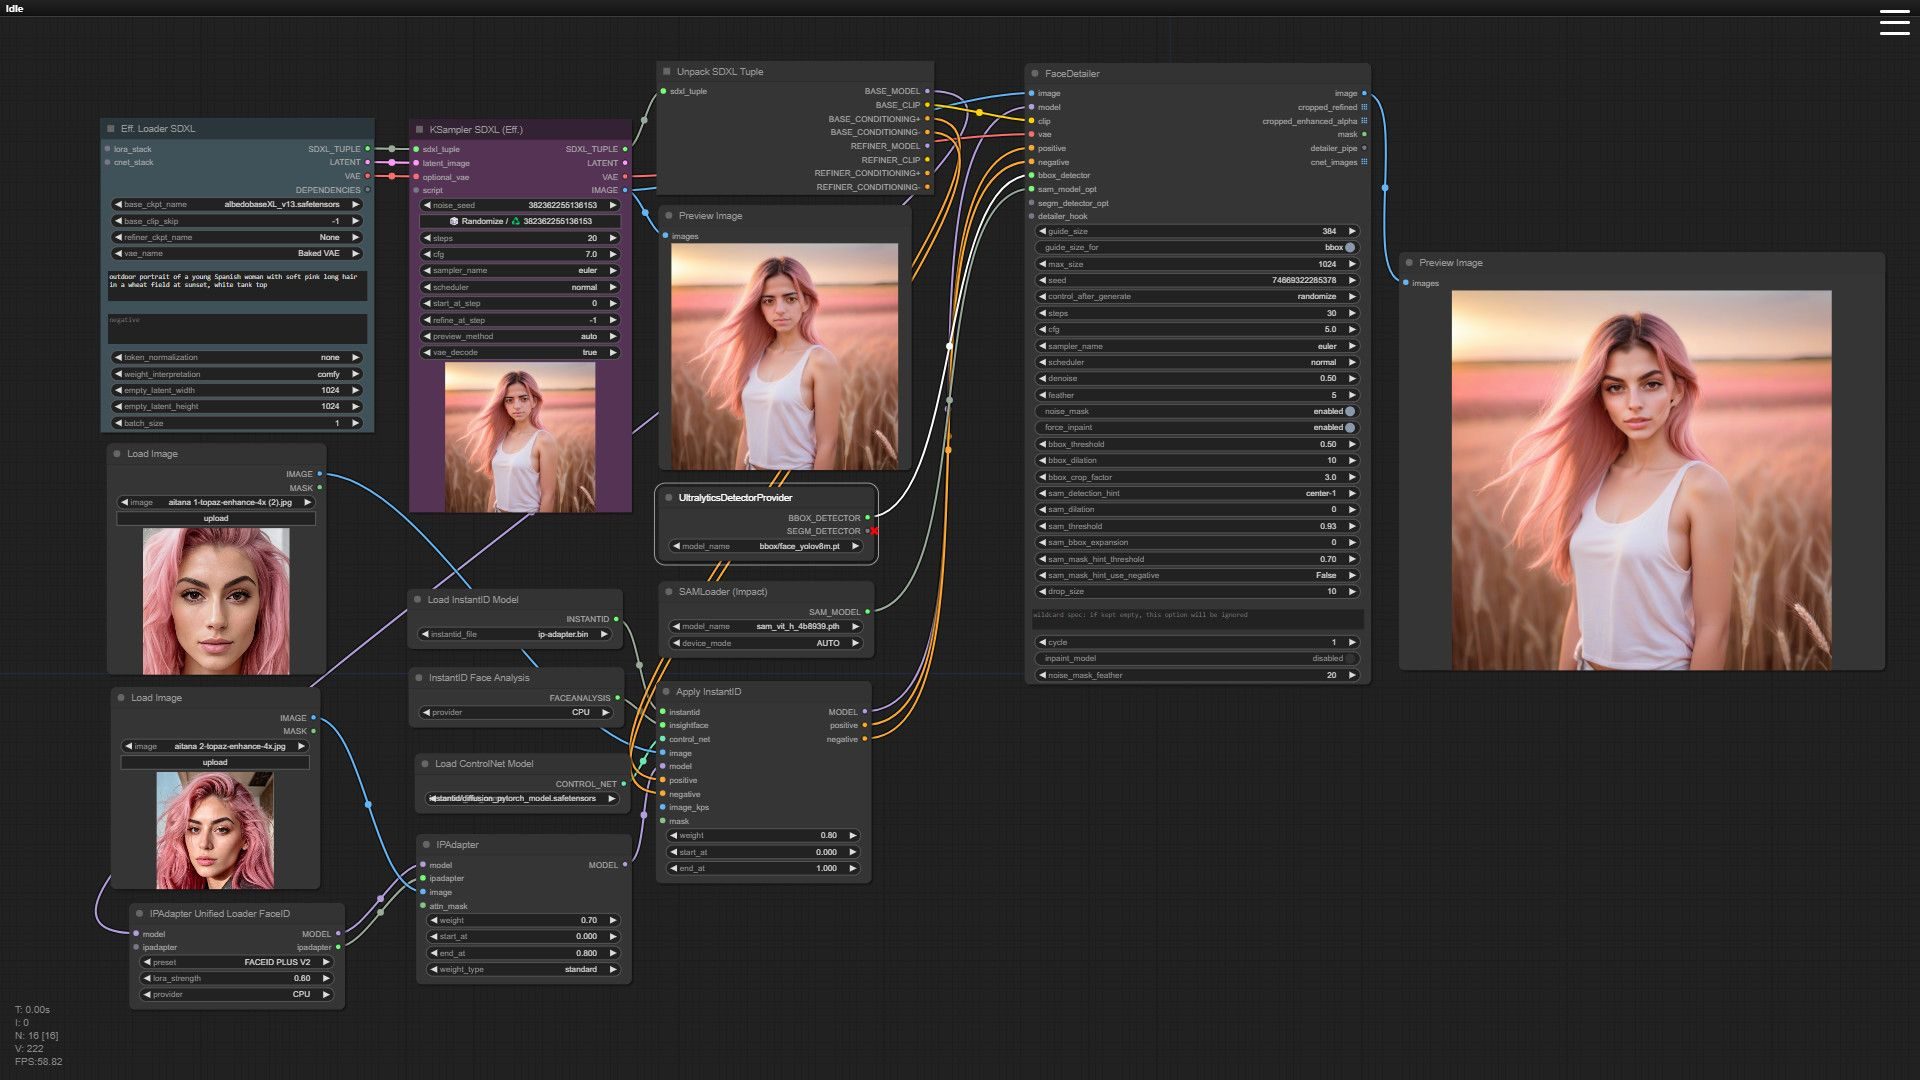
В ComfyUI память расходует вся схема генерации, включая энкодер и VAE
Видео: LTX-2.5 22B distilled через ComfyUI
Модель LTX-2.5 генерирует видео вместе со звуком. В ComfyUI откройте Templates → LTX-2.5 → Text-to-Video либо Image-to-Video. Кнопка Download all загружает компоненты шаблона. Для экономии памяти есть связка INT8 ConvRot с облегчённым видеодекодером VAE.
В неё входят дистиллированный трансформер и специализированный энкодер Gemma 4 в формате ComfyUI INT8 ConvRot, а также Conv video VAE. Диалоговая Gemma 4 12B-it этот энкодер не заменяет. Для звука и двухстадийной генерации нужны аудио-VAE и модуль увеличения разрешения из шаблона.
Файлы INT8 ConvRot предназначены для ComfyUI и не подходят для запуска через Python-пакет ltx-pipelines. При переходе с LTX-2.3 нужны совместимые компоненты. Число шагов зависит от схемы: двухстадийный DistilledPipeline выполняет восемь на первой стадии и четыре на второй.
Инструкция LTX для ComfyUI ориентирует на 32 ГБ видеопамяти и более, а также от 100 ГБ свободного диска. Это требования инструкции, не измеренный минимум оптимизированной INT8-связки. Для пробного задания задайте 768 × 512, 81 кадр и 24 кадра/с — около 3,4 секунды видео. Ширина и высота должны делиться на 32, число кадров — давать остаток один при делении на восемь. Пиковую память и время генерации измерьте на своём компьютере.
Нейросети для голоса и транскрибации
Whisper large-v3-turbo: расшифровка речи
Модель Whisper large-v3-turbo от OpenAI превращает запись в текст. У неё 809 млн параметров и сокращённый декодер. По данным разработчика, она быстрее large-v3 с небольшим снижением точности. Для русской речи проверьте скорость и ошибки на своей записи с именами, числами и шумом.
Для запуска подойдёт whisper.cpp с совместимыми конвертированными весами: Whisper — модель, а whisper.cpp — движок. Для перевода речи на английский OpenAI рекомендует другие многоязычные Whisper.
Qwen3-TTS 0.6B Base: синтез с образцом голоса
Qwen3-TTS-12Hz-0.6B-Base поддерживает русский среди десяти заявленных языков и клонирование голоса по образцу. Для запуска нужны пакет qwen-tts и метод generate_voice_clone. Base отличается от CustomVoice и VoiceDesign способом задания голоса — это не взаимозаменяемые файлы.
На своём тексте проверьте ударения, числа, сокращения и задержку. Семейство поддерживает потоковую выдачу. Для использования записи голоса нужны соответствующие права.
Программы для запуска: Ollama, LM Studio, llama.cpp, vLLM
Локальные нейросети запускают через графический интерфейс, командную строку или API — для личного диалога, редактора кода или сервиса команды.
| Программа | Кому подходит | Платформы и форматы | Существенное ограничение |
|---|---|---|---|
| LM Studio | Первый запуск, чат, локальный API | Windows, Linux, Apple Silicon. GGUF через llama.cpp | Версии приложения и скачиваемого движка различаются |
| Ollama | Локальный сервис для других приложений | Windows, Linux, macOS. Совместимые пакеты весов | Есть облачные варианты, проверьте место выполнения |
| llama.cpp | Ручная настройка, запуск на процессоре или GPU, частичная загрузка | Сборки под разные ОС, GGUF | Нужна поддержка конкретной архитектуры и оборудования |
| vLLM | Сервис с несколькими запросами | Основной путь — Linux, форматы зависят от архитектуры | Формат весов и серверную конфигурацию проверяют отдельно |
| Jan | Альтернативный настольный чат | Windows, Linux, macOS | Можно подключать внешних провайдеров |
| GPT4All | Настольный диалог и LocalDocs | Windows, Linux, macOS | Новые архитектуры должны поддерживаться его движком |
| ComfyUI | Изображения, видео и аудио | Локальные компоненты совместимой схемы | Отдельные узлы могут обращаться к внешним API |
Программы для локального запуска нейросетей
Для NVIDIA обычно используют CUDA, на Apple Silicon — Metal. Поддержка AMD и Intel зависит от движка, ОС и сборки. Перед покупкой видеокарты проверьте совместимость формата весов, оборудования и драйвера.
Первый запуск в LM Studio 0.4.28
Если локальная нейросеть на ПК нужна для первого знакомства, начните с процессора, 16 ГБ RAM и Qwen3.5-4B Q4_K_M. Инструкция основана на документации LM Studio 0.4.28. Для Windows x64 нужен AVX2, для Mac — Apple Silicon и macOS от 14.0.
- Установите приложение и совместимый движок llama.cpp, пока доступен интернет. Сохраните номера версий приложения и движка.
- В Discover найдите lmstudio-community/Qwen3.5-4B-GGUF. Выберите Qwen3.5-4B-Q4_K_M.gguf, 2,71 ГБ. Для этого текстового примера проектор изображений не нужен.
- В Chat откройте настройки загрузки: общий контекст 8192 токена,
GPU-offload = 0для запуска на процессоре. В параметрах модели отключите Enable Thinking для первой проверки. Позже можно включить рассуждения и сравнить время ответа. - Загрузите локальный файл и отправьте запрос: «Составь список из пяти пунктов, что проверить перед покупкой ноутбука». Посмотрите фактический расход памяти и время ответа.
- Отключите сеть и повторите запрос без сетевых инструментов и облачного провайдера. Так вы проверите автономность после скачивания компонентов.
Если файл не загружается, проверьте свободную память, требования приложения и поддержку архитектуры.
Перед первым запросом проверьте файл, длину контекста и размещение в памяти
Сколько видеопамяти и оперативной памяти нужно: таблица по классам
Видеопамять (VRAM) нужна не только весам. KV-кэш хранит данные внимания обработанных токенов, чтобы использовать их повторно. Место занимают и рабочие буферы, структуры движка, другие процессы. Поэтому длинная история и несколько запросов увеличивают расход.
Условия таблицы: один текстовый запрос, полный контекст до 8192 токенов с историей, входом, рассуждениями и ответом. Без визуальных компонентов и дополнительных ускорителей декодирования. Для GPU — полная загрузка через совместимый llama.cpp/CUDA на NVIDIA. Значения служат ориентиром для проверки на стенде.
Размеры файлов приведены в десятичных ГБ, как на Hugging Face. Бюджет RAM в GPU-строках рассчитан так: размер файла плюс условный резерв 16 ГБ на систему, загрузку и приложения, с округлением до указанной комплектации. Такой бюджет помогает выбрать комплектацию, но не задаёт минимум оперативной памяти.
| Память и платформа | Конкретный файл и размер | RAM: бюджет и загрузка | Что проверить |
|---|---|---|---|
| Процессор, 16 ГБ RAM | Qwen3.5-4B Q4_K_M, 2,71 ГБ | 16 ГБ, вычисления на процессоре | Свободную память и скорость процессора |
| 8 ГБ VRAM | Ministral 3 8B Instruct 2512 Q4_K_M, 5,20 ГБ | 32 ГБ, полная загрузка на GPU | Кэш и буферы при загрузке |
| 12 ГБ VRAM | Qwen3.5-9B Q4_K_M, 5,63 ГБ | 32 ГБ, полная загрузка на GPU | Запас под кэш и буферы |
| 16 ГБ VRAM | gpt-oss-20b MXFP4 GGUF, 12,1 ГБ | 32 ГБ, полная загрузка на GPU | MXFP4, Harmony и запас памяти |
| 24 ГБ VRAM | Qwen3.6-27B Q4_K_M, 19,4 ГБ | 64 ГБ, полная загрузка на GPU | Фактическую память после загрузки |
| 32 ГБ VRAM | Тот же Qwen3.6-27B Q4_K_M, 19,4 ГБ | 64 ГБ, полная загрузка на GPU | Потребление при более длинном контексте |
| 48 ГБ VRAM | Qwen3.6-27B Q8_0, 28,6 ГБ | 64 ГБ, полная загрузка на GPU | BF16 — другой файл, около 53,8 ГБ |
| 96 ГБ VRAM | gpt-oss-120b MXFP4 GGUF: две части, суммарно 63,4 ГБ | 128 ГБ, полная загрузка на GPU | Контекст и число параллельных запросов |
| Apple Silicon, 32 ГБ общей памяти | gpt-oss-20b MXFP4 GGUF, 12,1 ГБ | Единая память, Metal | Резерв macOS и приложений |
Ориентиры памяти для одного текстового запроса
Квантование указано для конкретных файлов. Для Gemma 4 12B-it Q8_0 ориентир — 24 ГБ видеопамяти, для двух кодовых вариантов Q4_K_M — 24–32 ГБ при тех же условиях. Частичный перенос весов в RAM меняет режим и задержки.
Локальные нейросети требуют больше памяти для длинной истории. Когда нужны более тяжёлые веса, большой контекст или длительная нагрузка, рабочая станция для запуска LLM подбирается под файл и сценарий, с проверкой видеопамяти и совместимости ПО.
Что меняется при контексте 32 768 токенов
У gpt-oss-120b по 18 слоёв полного и скользящего внимания, восемь KV-голов размером 64, скользящее окно — 128 токенов. Для одного запроса с кэшем FP16/BF16 расчёт даёт около 0,29 ГиБ KV-данных при 8192 токенах и 1,13 ГиБ при 32 768. Условие: движок освобождает старые данные скользящих слоёв. ГиБ — 2³⁰ байт.
Это нижняя оценка для кэша: резервирование блоков и рабочие буферы потребуют дополнительной видеопамяти. Поэтому разность между 96 ГБ и размером файла не показывает точный запас. Для четырёх и восьми активных последовательностей нужно отдельно оценить кэш и измерить пик памяти.
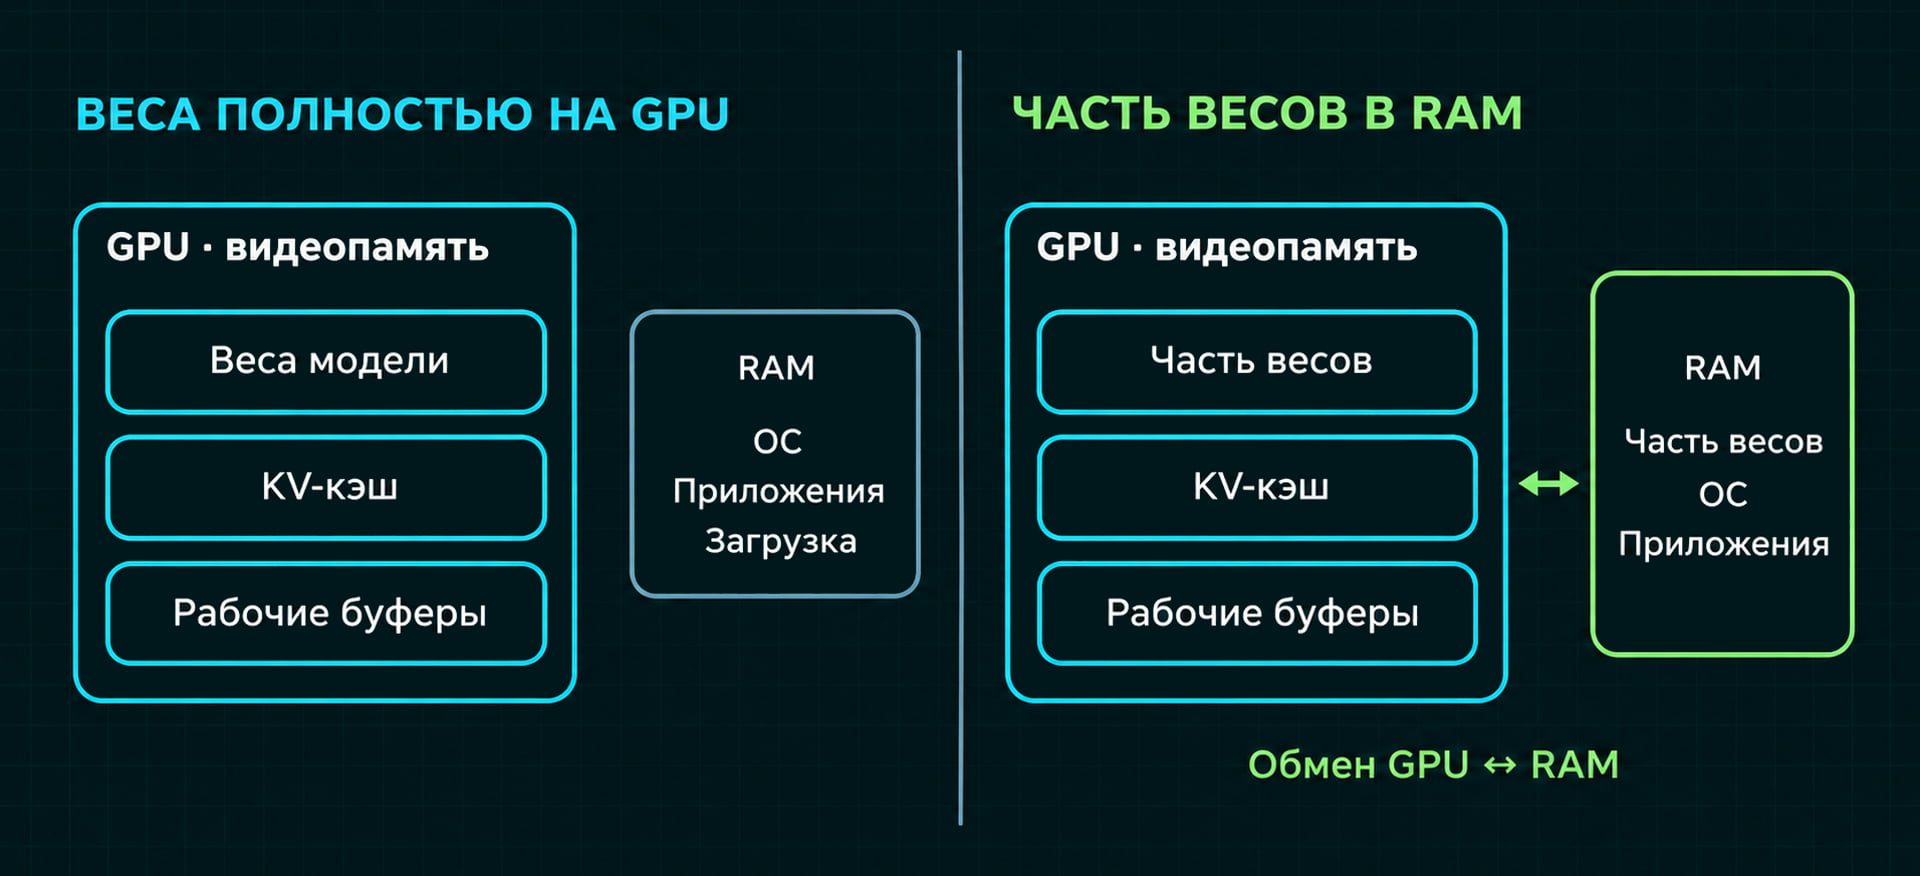
Размер весов — только часть памяти, которую занимает работающая модель
Для мультимедиа нужны отдельные условия:
| Задача | Выбранный процесс | Ориентир памяти | Условия проверки |
|---|---|---|---|
| Изображения | FLUX.2 [klein] 4B через ComfyUI | Минимум зависит от всей схемы | Разрешение, референсы, точность, размещение энкодера и VAE |
| Видео | LTX-2.5 distilled, связка INT8 ConvRot для ComfyUI | Инструкция ориентирует на 32 ГБ VRAM и более | Например, 768 × 512, 81 кадр, 24 кадра/с. Пик памяти и время измеряют |
Условия проверки памяти для изображений и видео
Какой компьютер нужен для локальной нейросети
Компьютер для локальной нейросети выбирают после файла и нагрузки. Для короткого чата на процессоре важны доступная оперативная память и её пропускная способность. Когда веса целиком на GPU, основной расчёт связан с видеопамятью, а процессор обслуживает приложение и сопутствующие задачи. Больше ядер не означает более быструю выдачу ответа.
Для кода и документов добавляются история проекта, поиск и инструменты. RAG — поиск фрагментов документов с передачей их генератору ответа. Эти этапы расходуют ресурсы и добавляют задержку. RAM пригодится сопутствующим службам, но не заменит видеопамять с той же скоростью.
Для изображений и видео учитывайте все компоненты схемы. На SSD нужно место под веса, кэш и рабочие данные, а для длительных заданий — подходящие питание и охлаждение. Перед выбором нескольких видеокарт проверьте, умеет ли движок разделять веса между ними: сумма памяти не становится единым пулом автоматически.
В DigitalRazor компьютер для локальной нейросети подбираем по файлу, рабочей нагрузке и допустимому времени ожидания.
Как в DigitalRazor подбирают систему под модель и нагрузку
Для подбора подготовьте название модели, квантование, движок, длины входа и ответа, число одновременно активных запросов и допустимую задержку. Для работы с документами добавьте поиск и другие службы. По этим данным проверяют размещение в памяти, совместимость ПО и видеокарты, затем — устойчивость под рабочей нагрузкой.
Каждая сборка Rackstation AI проходит у нас 72-часовой стресс-тест процессора, ускорителей и памяти под полной нагрузкой. Он проверяет стабильность системы. Для решений с gpt-oss предлагаем тестирование перед покупкой — условия запуска вашей задачи обсудим отдельно.
Пример DigitalRazor: зачем локальной LLM 96 ГБ памяти на одном GPU
Допустим, команде нужен gpt-oss-120b для выжимок и ответов по документам: сначала одному пользователю, затем нескольким. Кандидат — RACKSTATION AI RS64-96-384-A: одна NVIDIA RTX PRO 6000 с 96 ГБ, 64-ядерный AMD Threadripper PRO 9985WX и 384 ГБ DDR5. Точное исполнение GPU и среду запуска нужно уточнить для выбранной конфигурации.
OpenAI ориентирует gpt-oss-120b с MXFP4 на один GPU с 80 ГБ. Поэтому 96 ГБ — обоснованный вариант для размещения весов и рабочих данных без разделения между ускорителями. Расход при 8192 и 32 768 токенах нужно проверить в выбранном движке: короткий запрос не показывает потребление на длинном контексте.
Внешние испытания gpt-oss-120b на одной NVIDIA RTX PRO 6000 показывают, как параллельная нагрузка влияет на скорость генерации. В тестовом сценарии на каждый запрос приходилось 2048 входных и 2048 выходных токенов. Результаты получены на стороннем сервере и не являются измерениями Rackstation AI.
| Пакет запросов | Скорость одного ответа, токенов/с | Общая выдача, токенов/с | Первый токен, с |
|---|---|---|---|
| 1 | 160 | 160 | 0,11 |
| 4 | 112 | 448 | 0,30 |
| 8 | 99 | 792 | 0,46 |
Производительность gpt-oss-120b при параллельной обработке запросов
Суммарное количество токенов в секунду растёт, но каждый ответ выдаётся медленнее и начинается позже. Это измерения стенда Dell, не Rackstation. Версии ПО и формат весов раскрыты неполно, поэтому таблица показывает влияние параллельности в этом тесте, без прогноза для длинных документов и всего RAG-сервиса.
Четырём и восьми запросам нужно больше памяти под активные последовательности. Для подбора важны частота обращений и допустимая очередь, а не общее число сотрудников. Оперативная память 384 ГБ пригодится загрузчику, документам и поиску. Это не обязательный минимум: перенос вычислений или данных из VRAM в RAM меняет задержки и скорость.
Для личного чата на 4B–9B такая система избыточна. Для более крупной LLM или тяжёлой параллельной работы конфигурацию выбирают по тесту своей нагрузки — вплоть до перехода к другой инфраструктуре.


Лицензии: что можно использовать в бизнесе
Проверяйте условия конкретных весов отдельно от программы запуска: разрешения на один выпуск не распространяются на весь бренд.
| Выбранные версии | Лицензия весов | Коммерческое применение | Существенное условие |
|---|---|---|---|
| Qwen3.5-4B/9B, Qwen3.6-27B, Qwen3-Coder-30B-A3B-Instruct | Apache 2.0 | Допускается | Соблюдать условия лицензии выбранных весов |
| Gemma 4 12B-it | Apache 2.0 | Допускается | Условия прежних поколений Gemma сюда не переносятся |
| gpt-oss-20b/120b | Apache 2.0 | Допускается | Учитывать также лицензии движка и других компонентов |
| Ministral 3 8B Instruct 2512, Devstral Small 2 24B Instruct 2512 | Apache 2.0 | Допускается | Вывод относится к этим выпускам |
| FLUX.2 [klein] 4B | Apache 2.0 | Допускается | У 9B другие, некоммерческие условия |
| Whisper large-v3-turbo | MIT | Допускается | Сохранять необходимые уведомления при распространении |
| Qwen3-TTS-12Hz-0.6B-Base | Apache 2.0 | Допускается | Отдельно проверить права на исходный голос |
| LTX-2.5 | LTX-2.x Community License | С ограничениями | Учитываются выручка группы и характер продукта |
Лицензии выбранных версий моделей
Для коммерческого применения при годовой выручке группы от 10 млн долларов требуется платное соглашение. Для тестирования и оценки в непроизводственной среде предусмотрено исключение по пункту 2.2 лицензии — при соблюдении его условий
Частые ошибки при выборе модели
- Выбирать по бренду или активным параметрам. Сверьте точный выпуск и общий набор весов: активная часть MoE не показывает объём для хранения.
- Приравнивать файл к потреблению памяти. Кэш и буферы тоже занимают место. Проверьте фактическую видеопамять после загрузки и на рабочем запросе.
- Сразу ставить максимальный контекст. Начните с нужной длины: резерв под лишнюю историю занимает ресурсы.
- Покупать видеокарту до выбора ПО. Сначала проверьте поддержку архитектуры, формата и драйвера.
- Считать любой локальный чат автономным. Локальные нейросети могут работать рядом с облачным провайдером и сетевыми узлами. Проверьте маршрут запроса и повторите работу без сети.
- Ждать, что мощный сервер улучшит ответы. Дополнительная память позволяет загрузить более тяжёлые веса, но не исправляет ошибки выбранного варианта. Сравните ответы до покупки оборудования.
Часто задаваемые вопросы
Заключение
Лучшие локальные нейросети выбирайте на собственных заданиях: по точности пересказа, полезности правки кода и качеству озвучивания. Зафиксируйте файл, квантование, длину контекста и допустимое время ожидания, затем проверьте память и совместимость.
Если локальная нейросеть на ПК становится общим сервисом для команды, подберём GPU-сервер для ИИ по активным запросам и дополнительным службам. Передайте эти условия специалистам DigitalRazor — обсудим проверку конфигурации на вашей нагрузке.


