
Облачная или локальная LLM: сравнение для DevOps


Подберём сервер под задачи
Ответьте на несколько вопросов — подготовим предложение
Большая языковая модель (LLM) помогает разобрать инцидент, подготовить конфигурацию и найти инструкцию. Выбор между облаком и собственным сервером зависит от того, можно ли передавать данные наружу, насколько полезны ответы и какую нагрузку нужно обслуживать. Разберём, как выбрать LLM для DevOps и сравнить расходы на её использование и поддержку.
При подключении к внешнему облачному API модель обслуживает провайдер. Локальная LLM работает на собственной инфраструктуре: оборудование, обновления и доступ контролирует компания. Если разместить модель на арендованных GPU, команда сохранит управление ею, но данные будут обрабатываться на площадке арендодателя. Это вариант для пилота без покупки оборудования, если внешнее размещение разрешено.
Коротко: что выбрать DevOps-команде
- Внешнюю модель — для редких запросов, если передача данных разрешена, сервис доступен организации, а модель справляется с рабочими задачами.
- Собственный GPU-сервер — когда данные должны оставаться внутри компании либо стабильная загрузка позволяет снизить расходы. Потребуются подходящая модель и специалисты для эксплуатации.
- Гибридную схему — если закрытые данные нужно обрабатывать внутри, а часть разрешённых задач выгоднее поручать внешней модели. Для этого нужны классификация данных и контроль маршрута до отправки запроса.
Для каких задач DevOps используют LLM
Анализ логов и разбор инцидентов
Модель сопоставляет записи за нужный интервал с метриками и последними изменениями, группирует события и предлагает гипотезы о причинах сбоя.
Представим: в Kubernetes растёт число перезапусков, контейнер завершается с OOMKilled. Модель предлагает увеличить лимит памяти. Сначала инженер проверяет потребление, изменения приложения и признаки утечки. Если причина в утечке памяти, повышение лимита лишь отложит следующий сбой. Если лимит ниже нормального потребления приложения, его повышение может решить проблему.
Генерация и проверка конфигураций (IaC, пайплайны)
LLM готовит черновики Terraform, Ansible, манифестов Kubernetes и заданий CI/CD, объясняет изменения и ищет опасное расширение прав. Результат проверяют на синтаксис, работоспособность и безопасность.
Например, в запросе на слияние кода (PR) сетевое правило расширяет доступ с частной подсети до 0.0.0.0/0. Команда terraform validate проверяет синтаксис и внутреннюю согласованность конфигурации, поэтому такое изменение может пройти проверку. terraform plan покажет расширение доступа, а его допустимость определят политика компании и инженер.
Безопасная последовательность: форматирование и validate → статические проверки и политики → plan в контролируемой среде → проверка кода и плана → отдельное разрешение на apply. План может содержать секреты, а при его построении Terraform может обращаться к состоянию инфраструктуры и провайдерам. Поэтому недоверенную конфигурацию проверяют с минимально необходимыми полномочиями.
Code review и документация
При code review модель объясняет изменения, ищет подозрительную обработку ошибок и готовит вопросы автору. Она может пропустить дефект или предложить исправление работающего кода. Замечания проверяют тестами, анализаторами и экспертным ревью.
Документацию готовят по конкретной версии конфигурации: описывают параметры, зависимости и откат. DevOps-инженер сверяет команды и условия применения с действующей инфраструктурой.
Помощник по runbook и внутренней базе знаний
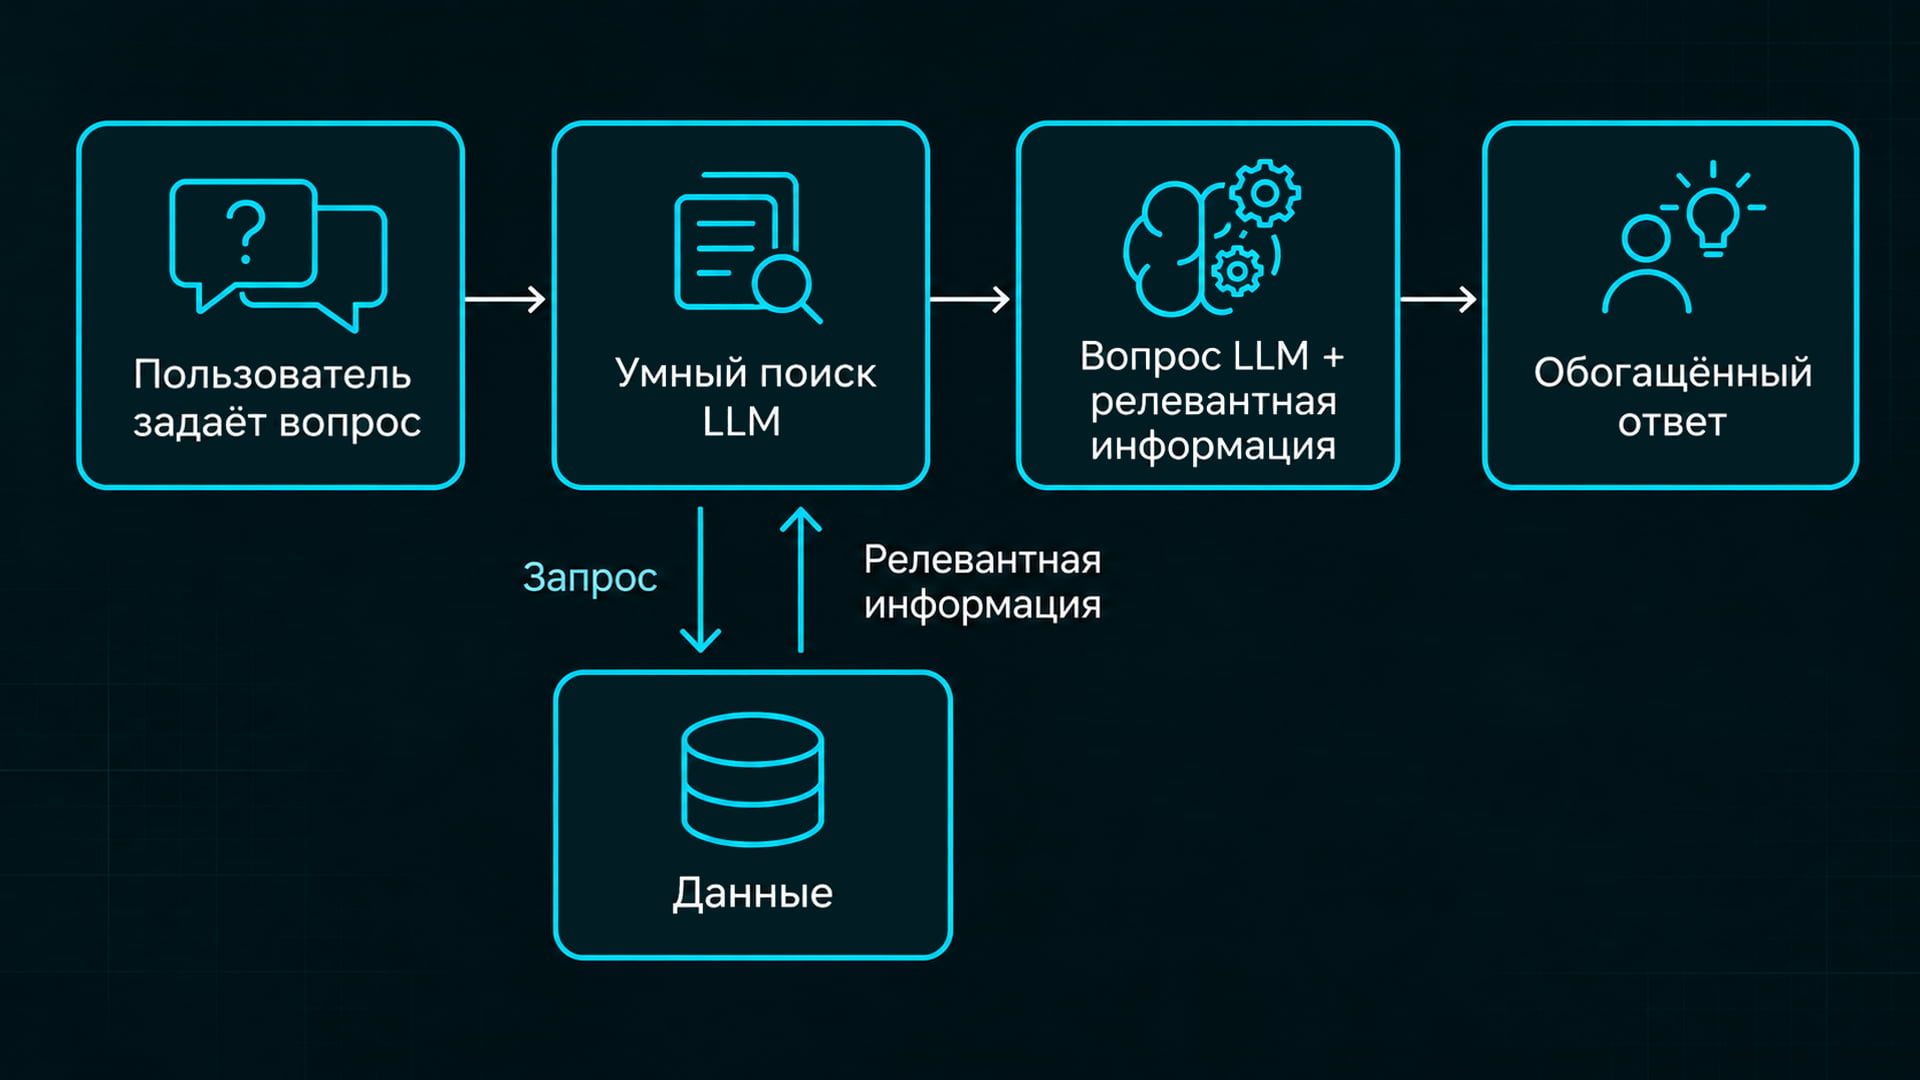
RAG — поиск по базе знаний с передачей найденных фрагментов модели. Так помощник отвечает по runbook — эксплуатационным инструкциям компании — и указывает источники.
Права пользователя проверяют ещё при поиске, чтобы модель получала только доступные ему документы. В ответе нужны ссылка, версия и дата инструкции. Если старая процедура рекомендует перезапуск базы, а новая запрещает его без согласования, помощник показывает актуальный документ или передаёт вопрос ответственному.
Облачная LLM: плюсы, ограничения и риски
Внешнюю модель подключают без закупки GPU и подготовки среды выполнения. Провайдер обслуживает оборудование, поэтому начать проще, особенно при нерегулярных запросах, когда собственный сервер простаивал бы.
Команде остаётся учитывать лимиты запросов, очереди, изменения версий и тарифов, зависимость от сети. Даже если провайдер способен нарастить мощности, квота клиента остаётся ограниченной. Для общего сервиса проверяют пиковую параллельную нагрузку, обработку отказов и бюджет.
На 7 ноября 2026 года Россия отсутствует в списках поддерживаемых регионов прямого доступа OpenAI и Anthropic. До подключения проверьте страну организации, регион обработки, договор и способы оплаты.
Какие DevOps-данные можно передавать в облако и как снизить риски
Безопасность кода и секретов начинается с классификации данных. У публичной документации и внутреннего репозитория разные условия передачи. Нужно учесть коммерческую чувствительность, права владельцев и договор с провайдером. Логи могут содержать персональные данные, адреса внутренних узлов и API-токены.
До отправки удаляют секреты и лишние поля, обезличивают записи. Даже после маскирования паролей структура инфраструктуры может оставаться конфиденциальной. Если очистить данные до разрешённого уровня нельзя, запрос обрабатывают внутри компании или отклоняют.
Использование данных для обучения и их хранение — разные условия. OpenAI API по умолчанию не использует данные для обучения, но журналы контроля злоупотреблений обычно сохраняются до 30 дней. У функций хранения состояния приложения свои правила. Проверяйте сроки хранения и удаления, состав журналов и условия работы подключённых инструментов.
Локальная LLM: плюсы, ограничения и риски
Локальная нейросеть позволяет контролировать размещение весов и запросов, сетевой маршрут и обновления. При полностью внутреннем выполнении данные не нужно передавать внешнему провайдеру. Это полезно для закрытых репозиториев и данных с ограничениями на передачу.
За безопасность кода и секретов отвечает компания. Приватность кода обеспечивают защита сети, отдельные учётные записи и контроль внешних подключений. Секреты могут утечь через журналы запросов, общую базу знаний или инструмент с чрезмерными правами.
Команда сама обновляет драйверы и ПО для выполнения модели, следит за совместимостью, организует мониторинг и восстановление. Зависимость от поставщиков сохраняется через оборудование, ПО и поддержку. Новую модель сначала проверяют на рабочих задачах.
Нужна помощь с выбором сервера?
Специалисты помогут подобрать оборудование под нагрузку, бюджет и задачи
Как проверить качество облачной и локальной модели
Место размещения не определяет качество. GPT-6.1 Sol — пример внешней модели, Qwen3.6-27B — кандидат для собственного размещения. Выбор между ними нужно подтвердить рабочими испытаниями.
У Qwen3.6-27B открытые веса под лицензией Apache 2.0, которая допускает коммерческое использование при соблюдении её условий. Доступные веса не означают, что вся ИИ-система полностью открыта. Перед внедрением проверьте документацию и условия модификации и распространения выбранного выпуска.
Диагностику, конфигурации, ревью и ответы по инструкциям оценивают отдельно. Для пилота возьмите одинаковый набор уже разобранных инцидентов, PR с известными дефектами и вопросов к документации. Дайте моделям одинаковый доступ к данным и инструментам.
Считайте пропуски, ложные замечания, выдуманные факты и время проверки ответов. Если компактная модель обеспечивает нужное качество, можно снизить требования к оборудованию.
Сравнение по критериям: качество, цена, задержка, безопасность, обслуживание
| Критерий | Внешняя модель | Свой сервер | Что меняет выбор |
|---|---|---|---|
| Качество | Модели из каталога провайдера | Совместимые модели и форматы весов | Результат на одинаковых задачах |
| Стоимость владения | Использование и интеграция | Покупка, интеграция и эксплуатация | Загрузка, длина запросов, качество и переделки |
| Задержка и параллельность | Сеть, очередь и квоты провайдера | Мощность узла, память и собственная очередь | Пиковая нагрузка и допустимое время ожидания |
| Контроль данных | Договор, регион и настройки хранения | Сеть, права и журналы под контролем компании | Класс данных и возможность их очистки |
| Обслуживание | Инфраструктуру ведёт провайдер | Весь стек обслуживает команда | Специалисты и требования к восстановлению |
| Доступность и рост нагрузки | Зависят от сервиса и выделенных квот | Требуют резерва ресурсов или новых узлов | Допустимый простой, сроки расширения и резервирование |
| Внешние зависимости | Сеть, оплата, региональные условия | Оборудование, драйверы и поддержка | Доступность поставщиков и план замены |
Скорость оценивают по времени до первого токена (TTFT), полному времени ответа, скорости генерации и суммарной пропускной способности. Токен — единица текста модели, часто часть слова. Быстрое начало ответа ещё не означает, что модель быстро завершит анализ.
При сравнении фиксируют модель, версию, длину входа и ответа, число параллельных запросов. Для локального узла — ещё и квантизацию, оборудование и движок выполнения, для внешнего API — регион клиента и сетевую задержку. Проверяйте задержку p95 — время, в которое укладываются 95% запросов, — под нагрузкой. Массовый запуск заданий CI/CD может создать очередь даже на быстром узле.
Как сравнить стоимость облачной LLM и собственного сервера
Полная стоимость владения (TCO) — расходы за выбранный срок эксплуатации. Если разделить их на число месяцев, получатся среднемесячные затраты. Срок окупаемости показывает, когда накопленная экономия покроет первоначальные вложения. Варианты сравнивают при одинаковой нагрузке и сопоставимом качестве, достаточном для рабочих задач.
Три сценария оплаты запросов
Ниже — условные месячные нагрузки. Вход включает инструкции и найденные документы, выход — все оплачиваемые токены ответа, включая токены рассуждений. Расчёт выполнен без учёта кэширования. Платные инструменты не используются.
Для GPT-6.1 Sol стандартная цена в поддерживаемых регионах — 2 доллара за миллион входных и 10 долларов за миллион выходных токенов. В рублёвом тарифе Yandex AI Studio для Qwen3.6 35B — 0,20 рубля за тысячу входных и 0,30 рубля за тысячу выходных, включая НДС. Это разные модели: их пригодность для одних и тех же задач проверяют отдельно.
| Нагрузка | Запросы в месяц × вход / выход | GPT-6.1 Sol, доллары | Yandex Qwen3.6 35B, рубли с НДС |
|---|---|---|---|
| Редкие обращения | 200 × 4000 / 1000 токенов | 3,60 | 220 |
| Регулярная работа | 5000 × 8000 / 2000 токенов | 180 | 11 000 |
| Интенсивный общий сервис | 50 000 × 12 000 / 3000 токенов | 2700 | 165 000 |
Тарифы проверены 7 ноября 2026 года
Формула: число запросов × (входные токены × тариф входа + выходные токены × тариф выхода). Единицы токенов должны соответствовать тарифу. Например, в регулярном сценарии для Yandex 40 млн входных токенов стоят 8000 рублей, а 10 млн выходных — 3000. Итого — 11 000 рублей.
У GPT-6.1 Sol чтение кэшированного входа стоит 0,10 доллара за миллион токенов, запись с минимальным сроком 30 минут — 2,50 доллара за миллион. Если в регулярном сценарии 20 млн входных токенов читаются из кэша, а остальные 20 млн записываются, расходы составят 152 доллара: 2 за чтение, 50 за запись и 100 за выход. Оценивайте экономию по фактическим объёмам чтения, записи и обычного входа. Без повторного использования данных платная запись в кэш может увеличить счёт.
Что включить в расходы на свой сервер
Для расчёта нужны цена конфигурации, срок использования и расходы на эксплуатацию. При сравнении коммерческих предложений проверьте НДС, доставку, настройку и условия гарантии. Модель среднемесячных затрат:
Цена оборудования / срок в месяцах + энергия + размещение и сеть + администрирование + обслуживание и ремонт + необходимые лицензии и резервирование
Энергию считают по среднему потреблению всей системы с учётом простоя, а не по предельной мощности GPU. Если используете PUE — отношение энергии всей площадки к энергии ИТ-оборудования, — охлаждение уже входит в этот множитель. Повторно добавлять его электрическое потребление нельзя.
При редких обращениях расходы на покупку и сопровождение распределяются на небольшое число задач. С ростом загрузки стоимость одной задачи снижается, пока сервер выдерживает пики без расширения конфигурации. Второй узел для производительности или резерва нужно включить в расчёт.
Аренда GPU заменяет покупку оплатой времени использования. Дополнительно учитывают диск, трафик и сопровождение. При круглосуточной работе аренда может оказаться дороже покупки.
Ориентир для сравнения — расходы на сопоставимую облачную нагрузку из таблицы. Собственное решение экономичнее, если его полные среднемесячные расходы ниже при сопоставимом качестве и доступности. Учитывайте время проверки и исправления ответов: дешёвая генерация теряет преимущество, если инженер тратит больше времени на переделку. Срок окупаемости оценивают по конкретному коммерческому предложению и денежной экономии на эксплуатации, учитывая покупку как первоначальное вложение.
Что нужно для локального запуска: сервер, Ollama, vLLM, интеграции
Модель, память и аппаратная конфигурация
При выборе сервера для ИИ учитывают модель, формат весов и длину контекста. Квантизация уменьшает число бит на представление параметров и сокращает объём памяти. Её влияние на качество проверяют на рабочих задачах.
Языковая часть Qwen3.6-27B содержит около 27 млрд параметров. Её веса теоретически занимают примерно 54 ГБ при 16 битах, 27 ГБ при 8 битах и 13,5 ГБ при 4 битах. Дополнительно нужны служебные данные формата, буферы и KV-кэш — сохранённые промежуточные данные механизма внимания, которые модель использует при генерации продолжения. Если загружается и визуальный кодировщик, учитывают также его память. Поэтому объём весов не равен требуемой видеопамяти.
Контекстное окно ограничивает суммарную длину входа и ответа. Длинный контекст и параллельные запросы требуют больше памяти. Для пилота 4-битной модели класса 27B можно начать испытания с GPU на 24–48 ГБ, ограничив контекст и параллельность. Для общего сервиса запас памяти определяют по пику запросов и допустимой задержке.
У NVIDIA RTX PRO 6000 Blackwell Server Edition 96 ГБ видеопамяти. Этот объём даёт место под веса и контекст, но сам по себе не гарантирует скорость. Если модель помещается на одной карте с запасом, распределять её между ускорителями обычно незачем.
У моделей со смесью экспертов (MoE) в обработке одного токена участвует только часть параметров. Например, у Qwen3.5-397B-A17B их 397 млрд всего и 17 млрд активных. При подборе памяти учитывают общий объём весов и способ загрузки экспертов.
Для работы на нескольких GPU нужны поддержка распределённого выполнения и подходящие межсоединения. Две карты по 48 ГБ не заменяют автоматически одну на 96 ГБ. Если модель уже помещается на одной карте, для обслуживания большего числа параллельных запросов иногда полезнее запустить её копии на других GPU. GPU-кластер подбирают по требованиям к масштабу и доступности.
CPU и оперативная память нужны для подготовки запросов, загрузки весов и сопутствующих сервисов. Накопители хранят модели и индексы, сеть обеспечивает доступ и обмен между узлами в распределённой системе. При подборе GPU-сервера учитывают также поиск по документам, мониторинг и резервное копирование.
Для собственного размещения у DigitalRazor есть серверы и рабочие станции для локальных LLM. Для узла с одной-двумя видеокартами можно рассмотреть Rackstation AI. Конфигурацию выбирают под модель, контекст и параллельную нагрузку, а время ответа подтверждают испытаниями.
Выберите GPU-сервер для нейросетей
Готовые решения для работы с большими массивами данных
Личный пилот и общий сервис команды
Для персонального пилота удобен Ollama. Он поддерживает и облачные модели, поэтому при работе с закрытыми данными проверьте режим запуска, отключите облачные функции и контролируйте сетевые обращения.
Практический пример помощника с Ollama и поиском по документам разобрали в руководстве по запуску ИИ-агента на сервере или VPS.
Для общего сервиса подходит vLLM — движок инференса, то есть ПО для выполнения модели. Он позволяет настраивать параллельную обработку запросов и распределение по GPU. Перед запуском проверьте совместимость с моделью, форматом весов и оборудованием.
Доступ организуют через внутренний API со шлюзом, аутентификацией, правами и квотами. К нему подключают чат, проверку PR или поиск по инструкциям. Для эксплуатации нужны ограничения запросов, защита журналов, контроль памяти и очереди, возможность откатить обновление.
Рекомендации проверяет человек. Если модели доступны инструменты, она предлагает вызов, а отдельный контроллер проверяет права и условия выполнения. Изменения вносят через служебные учётные записи с минимальными полномочиями, действия записывают в журнал.
Логи и документы могут содержать вредоносные инструкции для модели — prompt injection. Система должна обрабатывать найденный текст как данные, а права и правила выполнения задают вне модели. Ответ не должен обходить проверку политик и согласование изменений в рабочей инфраструктуре.
Гибридная схема: что держать локально, что отдавать в облако
Шлюз проверяет пользователя и права на источники, классифицирует данные, удаляет секреты и персональные сведения. Затем выбирает разрешённый маршрут с учётом качества, цены и времени ответа.
Например, диагностика по внутренним логам остаётся в компании, а пояснение по публичной документации отправляется внешней модели. Если безопасный внешний запрос сформировать нельзя, система отказывает в отправке или передаёт вопрос инженеру. Перегрузка внутреннего узла не отменяет ограничений на передачу закрытых данных наружу.
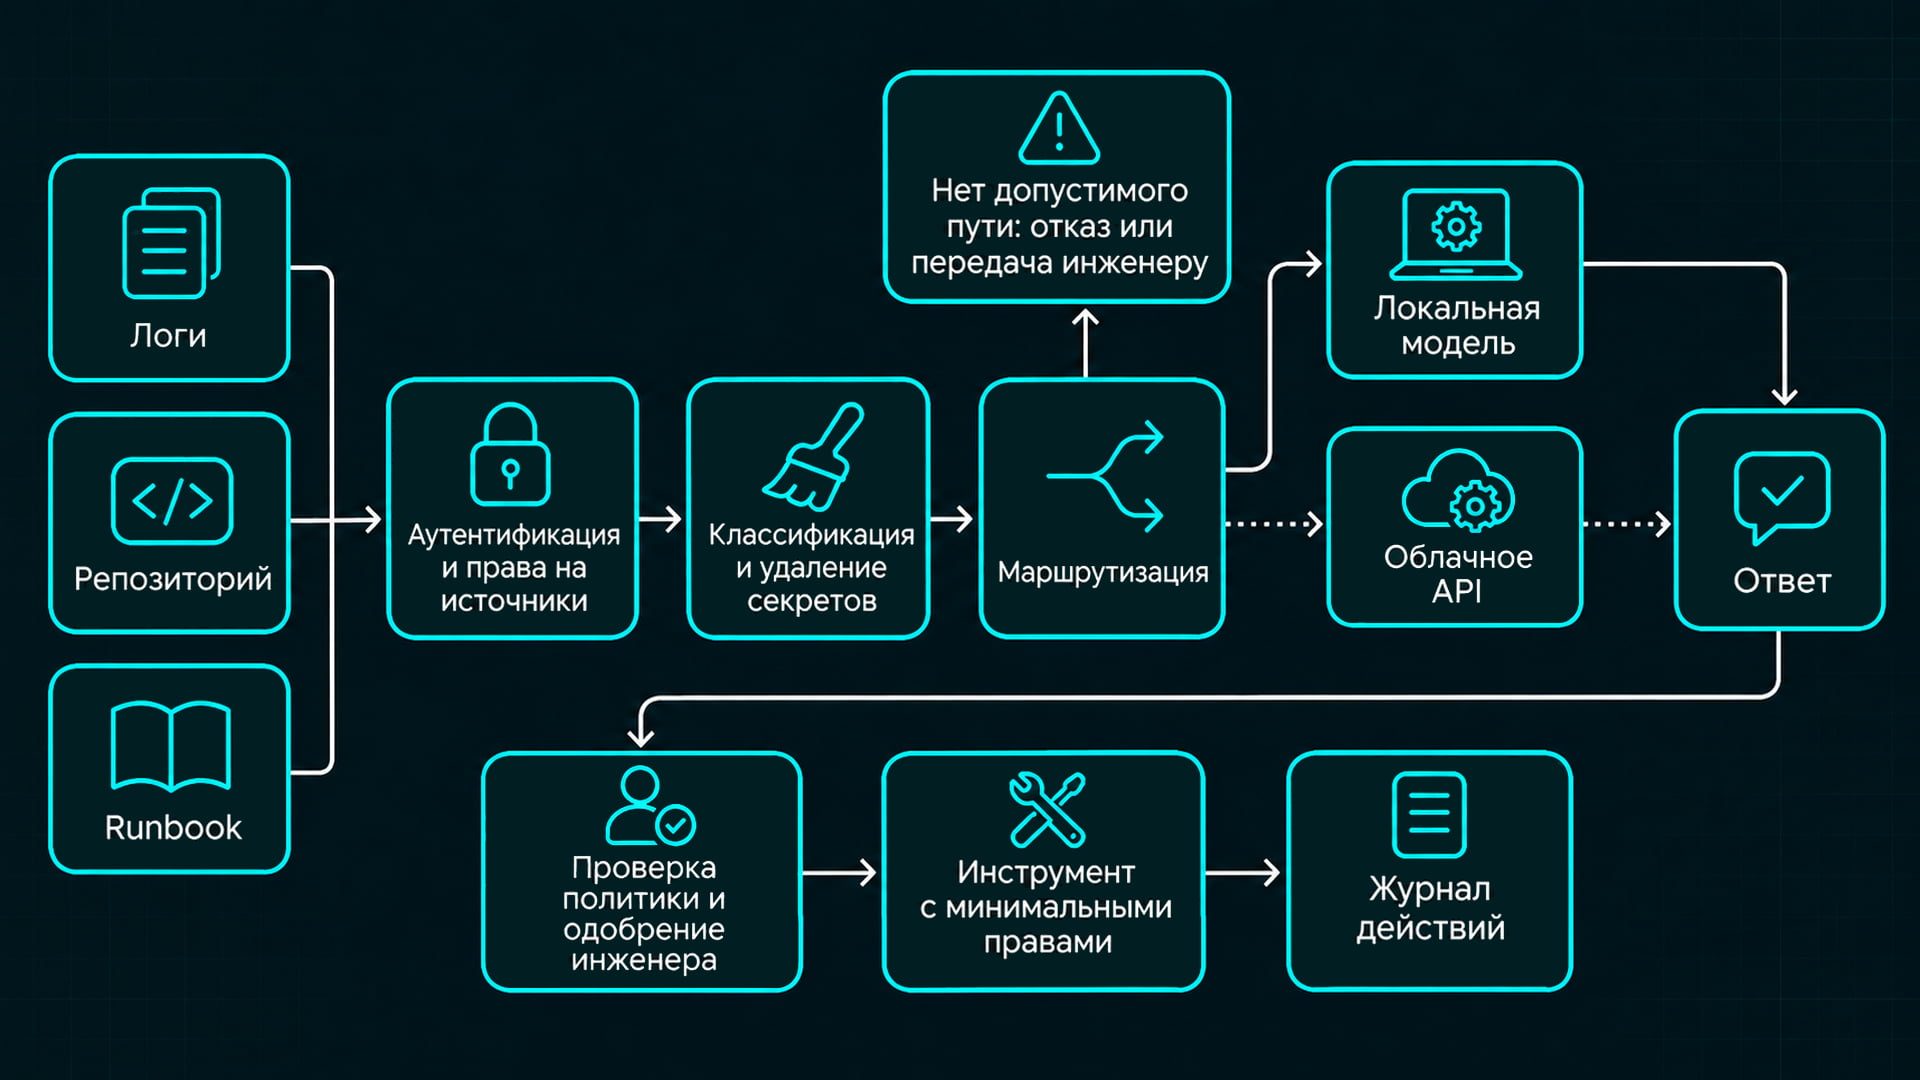
Разрешение на передачу данных и разрешение на изменение инфраструктуры проверяют отдельно
Как выбрать: короткий алгоритм решения
- Составьте карту задач и данных. Укажите источники, владельцев и разрешённые места обработки. Исключите запрещённые маршруты.
- Задайте критерии. Определите допустимые ошибки, время ответа и порядок проверки инженером. Подготовьте задачи с известным правильным решением.
- Измерьте нагрузку. Соберите данные о длине и числе запросов, пиках параллельности. Среднее за день не отражает нагрузку при массовом запуске проверок PR.
- Сравните расходы. Рассчитайте оплату запросов, покупку и аренду с учётом сопровождения, резерва и исправления ответов.
- Проверьте условия эксплуатации. Уточните региональные ограничения, способы оплаты, квоты, сроки поставки и ответственных за восстановление.
- Проведите пилот. Начните с рекомендаций без права менять инфраструктуру. По результатам выберите архитектуру, которая отвечает требованиям к данным, качеству, нагрузке и расходам.
Часто задаваемые вопросы
Заключение
Локальная LLM позволяет DevOps-команде анализировать закрытые логи, проверять код и работать с внутренними инструкциями в корпоративной сети. Компания сама управляет доступом и обновлениями модели. При стабильной загрузке свой сервер может обходиться дешевле облачного API. Экономию оценивают по полной стоимости владения при сопоставимом качестве ответов.
Начните с пилота на своих PR и runbook, без права менять инфраструктуру. Он поможет оценить качество ответов, задержки и требования к оборудованию.
DigitalRazor более 10 лет разрабатывает и производит рабочие станции и GPU-серверы. Для локального запуска LLM подберём GPU и объём памяти с учётом модели, длины контекста и параллельной нагрузки. Проверим совместимость компонентов и учтём планы расширения.
Нагрузочные испытания собранной системы занимают до 48 часов. Отдел контроля качества оценивает результаты перед отправкой, а собственный сервисный центр помогает с обслуживанием после поставки.
Напишите в MAX или Telegram — расскажите о задачах команды, бюджете и ожидаемом пике запросов. Поможем подобрать сервер для пилота или постоянного сервиса с учётом требований к доступности.

RS24-32-256

RS32-64-256

RS32-48-512


