
Сервер для виртуализации: как выбрать железо под виртуальные машины


Подберём сервер под задачи
Ответьте на несколько вопросов — подготовим предложение
Чтобы выбрать сервер для виртуализации, недостаточно сосчитать будущие ВМ. Нужно понять, какие задачи они выполняют одновременно, сколько памяти занимают и какой простой допустим для бизнеса. Разберём порядок расчёта, выбор компонентов и ситуации, в которых одного хоста уже недостаточно.
Что такое сервер виртуализации и когда он нужен
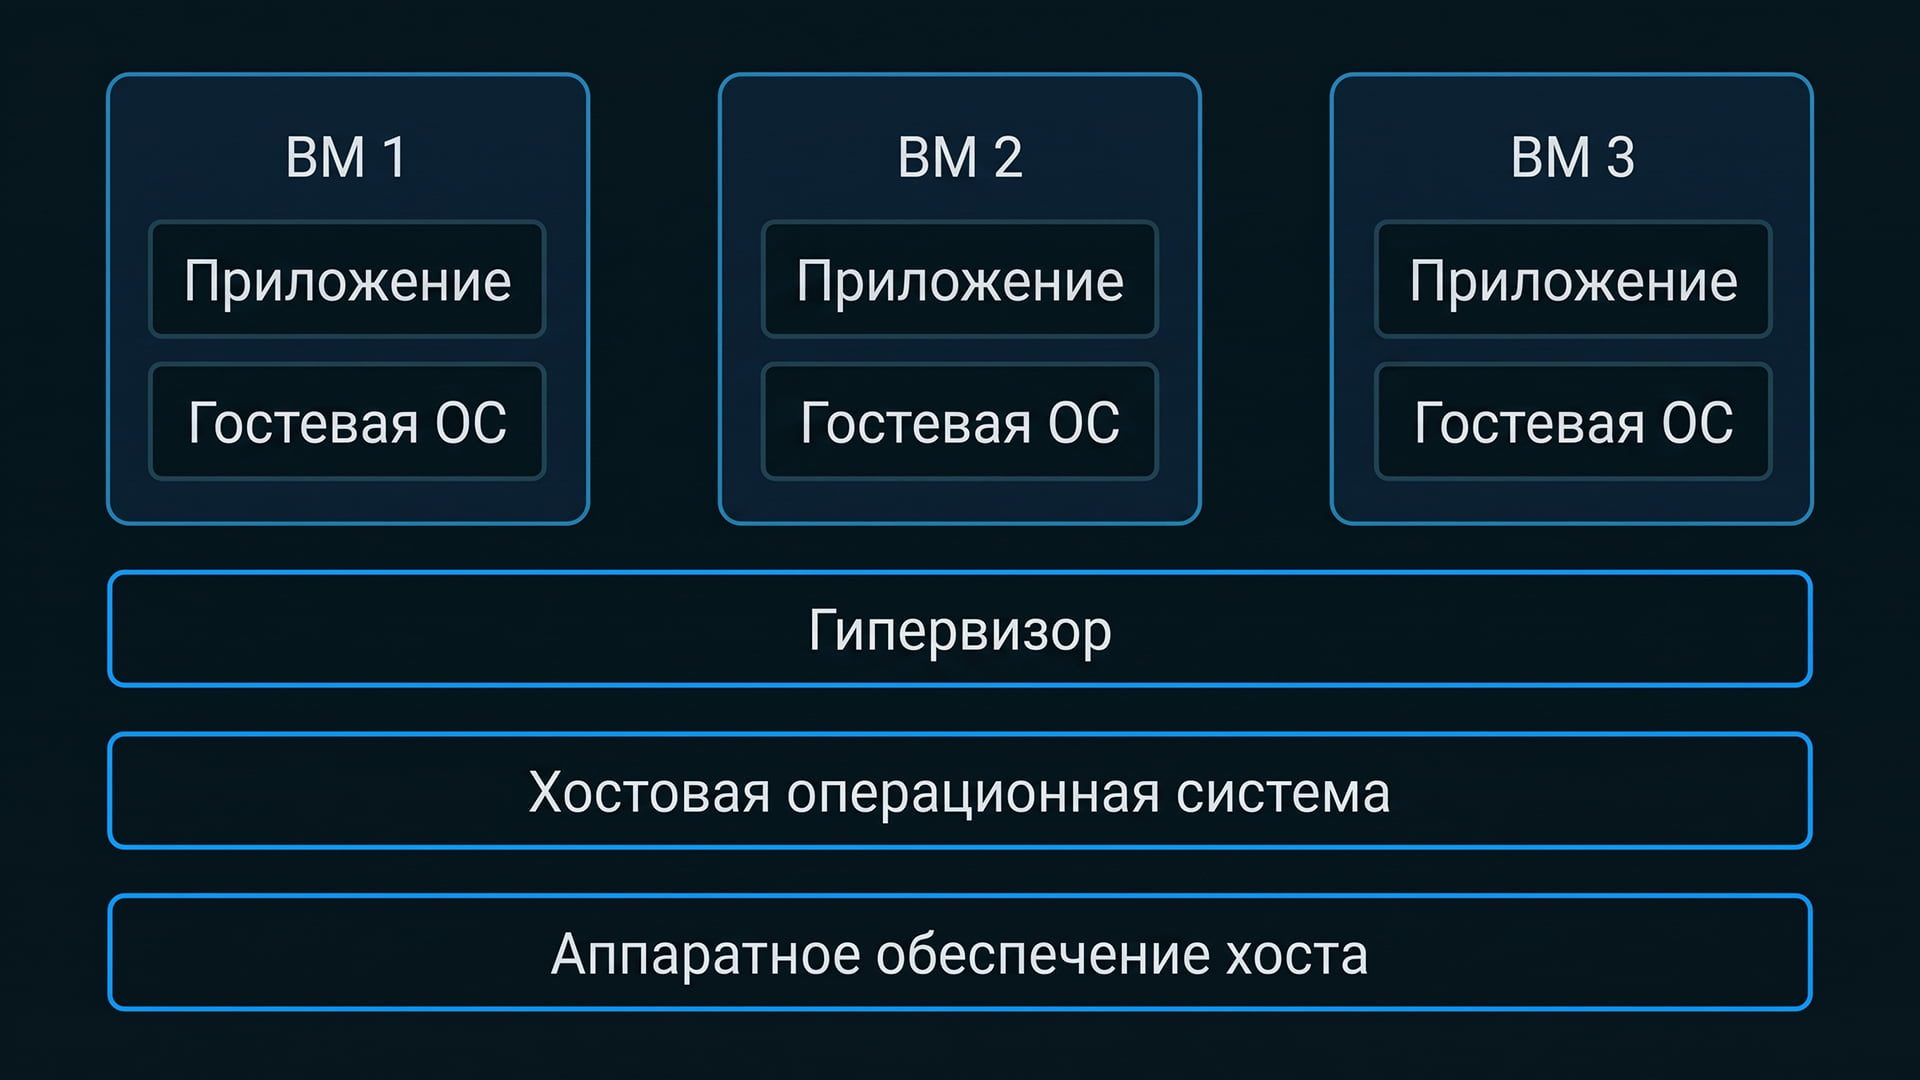
Сервер виртуализации — физический компьютер, ресурсы которого распределены между несколькими гостевыми операционными системами. Приложение 1С, база данных, файловый сервис и тестовая среда работают раздельно, хотя используют общее оборудование. Распределением ресурсов и изоляцией занимается гипервизор.
В отличие от установки всех приложений в одну ОС, такой подход позволяет независимо обновлять и перезапускать сервисы, переносить их между совместимыми хостами и восстанавливать из копий. Но изоляция не создаёт дополнительные вычислительные мощности: соседние ВМ продолжают конкурировать за CPU, память и диски.
Виртуализация серверов полезна при консолидации нескольких сервисов, развёртывании тестовых сред и планировании восстановления. Она не гарантирует экономию в любом проекте. В бюджет входят не только комплектующие, но и лицензии, резервные копии, обслуживание и время администратора. Отказ единственного хоста затронет все размещённые на нём сервисы.
Гипервизоры первого и второго типа
Первый тип, bare-metal, управляет аппаратными ресурсами непосредственно. Управляющая ОС при этом может быть частью архитектуры. Например, наличие Windows в серверной платформе Microsoft не превращает её в решение второго типа.
Второй тип, hosted, работает поверх обычной хостовой ОС как приложение. Это удобный вариант для лаборатории или проверки программы. Для постоянной работы бизнес-сервисов выбирают серверную платформу с подходящими средствами управления, мониторинга и восстановления.
Сам гипервизор и платформа управления — не одно и то же. Возможность запустить гостевую ОС ещё не означает наличие автоматического восстановления, миграции и интеграции с системой резервных копий. Эти функции проверяют отдельно.
С чего начать: как посчитать нагрузку
Сначала согласуют допустимую потерю данных и время восстановления, затем оценивают ресурсы. Сервер для виртуальных машин, который подходит по производительности, может не подойти по доступности: переждать ремонт файлового архива и остановить продажи на несколько часов — разные сценарии.
Измерения должны охватывать характерный рабочий цикл: обычный день, закрытие периода в 1С, массовый вход пользователей, резервное копирование. Пятиминутный график в спокойный час не показывает, что произойдёт при совпадении нагрузок. Для нового сервиса используют пилот с представительными данными и согласованным числом одновременных операций.
Общие вопросы размещения, обслуживания и выбора оборудования разобраны в материале «Как выбрать сервер для небольшой компании». Для виртуальной инфраструктуры к ним добавляется профиль каждого гостя.
Инвентаризация виртуальных машин: ядра, память, диски, сеть
Для каждого сервиса фиксируют назначенные ресурсы, фактическое потребление, пики, критичность и ожидаемый рост. Назначенные 8 vCPU не означают постоянную загрузку восьми физических ядер. А виртуальный диск на 500 ГиБ может содержать гораздо меньше данных.
Ниже — условная небольшая компания без графических рабочих мест. Это учебные назначения ресурсов, а не замеры или требования конкретной конфигурации 1С. ГиБ обозначают двоичные единицы ёмкости.
| Сервис | vCPU | RAM, ГиБ | Диск, ГиБ |
|---|---|---|---|
| Контроллер домена | 2 | 8 | 80 |
| Приложение 1С | 4 | 16 | 160 |
| База данных | 4 | 24 | 240 |
| Файловый сервис | 2 | 8 | 400 |
| Мониторинг | 2 | 4 | 80 |
| Итого | 14 | 60 | 960 |
К таблице потребуются четыре группы измерений:
- CPU: загрузка в периоды совместной работы, время ожидания выполнения vCPU и длительность важных операций.
- RAM: рабочее потребление, использование подкачки, требования кешей и пиков при запуске сервисов.
- Диски: IOPS, размер блока, доля чтения и записи, последовательность обращений и задержки в пиковые часы.
- Сеть: пользовательский трафик, передача копий, обращения к внешнему хранилищу и миграции.
IOPS — количество операций ввода-вывода в секунду. Одинаковые IOPS при разных размерах блока и долях записи не означают одинаковую нагрузку. Поэтому одной паспортной скорости SSD для расчёта недостаточно.
Пример расчёта хоста для небольшой компании
Память. В таблице гостям назначено 60 ГиБ. Предположим рост потребности на 20% и ещё 8 ГиБ для ОС хоста и служебных процессов:
60 + 60 × 0,2 + 8 = 80 ГиБ.
Для пилотной конфигурации можно рассматривать 128 ГиБ ECC. Конкретную схему модулей выбирают по числу каналов и правилам заполнения слотов. Резерв 8 ГиБ — допущение примера, а не универсальная норма. При использовании ZFS, распределённого хранения или дополнительных служб его пересчитывают.
Диски. Если нужно обеспечить весь назначенный объём, а не рассчитывать на его частичное заполнение, исходная потребность равна 960 ГиБ. При условном росте на 30%:
960 × 1,3 = 1 248 ГиБ логической ёмкости.
Зеркало из двух SSD по 1,92 ТБ даёт ёмкость одного устройства, а не сумму двух. До форматирования это примерно 1 788 ГиБ: 1,92 × 10¹² / 2³⁰. После размещения расчётных 1 248 ГиБ остаётся около 540 ГиБ под служебные расходы, временные снимки и свободное пространство. Достаточность этого запаса проверяют по политике хранения. Резервные копии в него не включены.
CPU. Сумма 14 vCPU не позволяет вычислить необходимое число физических ядер. Для этого примера в качестве кандидата для нагрузочного теста можно взять односокетную серверную платформу с 12–16 современными ядрами. Это предварительный класс оборудования, а не доказательство, что любой такой CPU справится с базой данных.
Итоговый кандидат: один CPU указанного класса, 128 ГиБ ECC, отдельный загрузочный том, зеркальная пара корпоративных SSD с защитой от потери питания, серверный сетевой адаптер, BMC и резервируемые БП. NVMe имеет смысл проверять под фактический профиль дисковых обращений. Сеть 10GbE рассматривают, когда её требует объём обмена и поддерживает остальная инфраструктура, а не просто потому, что в таблице пять ВМ.
На пилоте проверяют совместную работу сервисов, длительность операций 1С, задержки БД и влияние создания копий. Такой сервер виртуализации остаётся одиночной точкой отказа. Если ремонтный простой неприемлем, расчёт повторяют для нескольких узлов и режима отказа одного из них.
Расчёт помогает сформировать требования к оборудованию, но не заменяет проверку конфигурации. При сравнении серверов полезнее смотреть на поддержку ECC, организацию дискового пула, удалённое управление и возможности расширения, чем на условное количество ВМ.
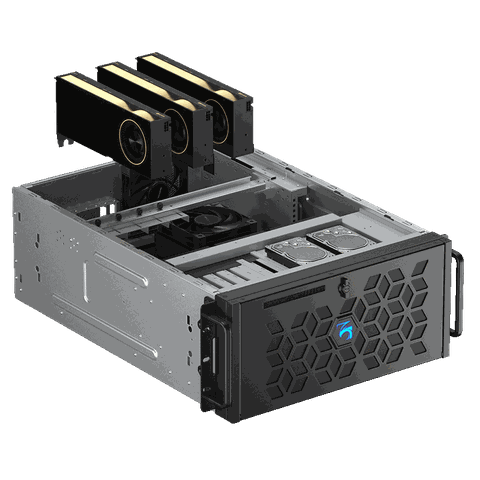
Процессор: ядра, частота и количество сокетов
Ядра процессора определяют доступный параллелизм, но не заменяют производительность отдельного потока. Множество небольших сервисов и одна загруженная база данных могут требовать разных CPU при одинаковой сумме vCPU.
Для 1С и СУБД сначала выясняют, что задерживает рабочую операцию: последовательный участок вычислений, блокировки, память или дисковый ввод-вывод. Добавление ядер не устранит ожидание диска. Максимальная турбочастота из спецификации тоже не описывает работу всех ядер под продолжительной нагрузкой.
Односокетная система подходит, когда один CPU обеспечивает нужную производительность, объём памяти и число линий PCIe. Два сокета выбирают ради подтверждённой потребности в дополнительных ресурсах. Это не обязательный признак «настоящего» сервера и не бесплатное удвоение возможностей.
В многосокетных системах важна NUMA: доступ к памяти локального узла и к памяти соседнего узла различается по задержке. NUMA встречается и внутри отдельных односокетных платформ. Для крупной ВМ проверяют её виртуальную топологию и размещение памяти, а не просто назначают побольше vCPU.
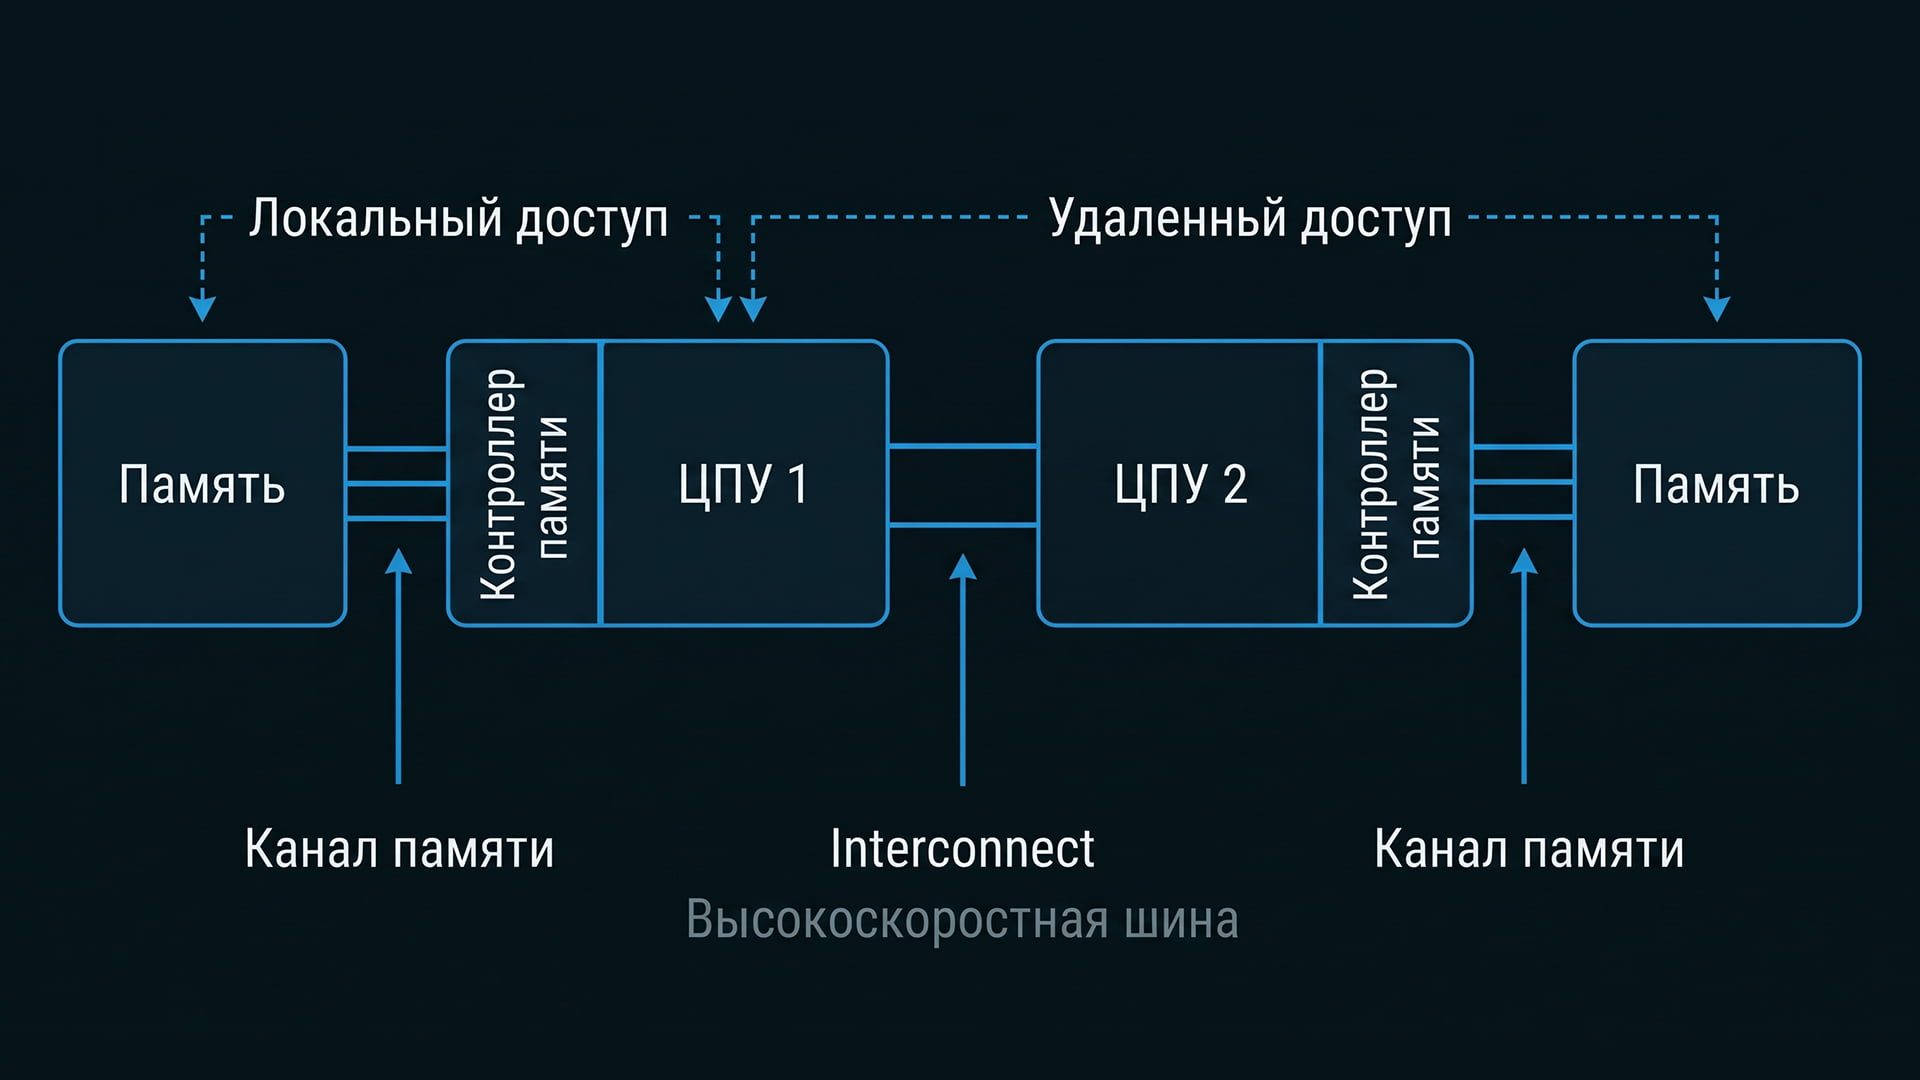
Перед покупкой сверяют поддержку аппаратной виртуализации Intel VT-x или AMD-V. Для прямой передачи устройств нужна IOMMU, например Intel VT-d или AMD-Vi. Проверка охватывает CPU, плату, прошивку, гипервизор и драйверы, а не только галочку в характеристиках чипа.
Соотношение vCPU и физических ядер
vCPU — виртуальный процессор, который планировщик распределяет по вычислительным ресурсам хоста. SMT позволяет одному физическому ядру исполнять несколько аппаратных потоков, но не превращает его в два равноценных ядра.
Оверкоммит CPU — назначение гостям большего количества виртуальных процессоров, чем выбранная база физических вычислительных ресурсов. Например, отношение суммарных vCPU к физическим ядрам описывает плотность назначения, но не загрузку. В документации и мониторинге нужно уточнять, считают ли коэффициент по физическим ядрам или логическим потокам.
У редко активных офисных служб пики могут не совпадать, поэтому ресурсы удаётся разделять. Для постоянно загруженной БД запас важнее высокой плотности. В VDI отдельно проверяют одновременный вход пользователей. Универсального правила «одно ядро на четыре vCPU» нет.
Начинают с обоснованного числа vCPU и увеличивают его по результатам теста. Чрезмерные назначения усложняют планирование и могут не дать выигрыша приложению, которое не использует дополнительный параллелизм.
Оперативная память: объём, ECC и каналы
Для предсказуемой работы оперативная память должна покрывать одновременные потребности гостей, системные расходы и согласованный резерв. В расчёте выше используется вся назначенная RAM. Экономию за счёт перераспределения памяти заранее не закладывают.
Ballooning и динамическая память позволяют менять доступный гостю объём при поддержке ОС и драйверов. Они полезны, пока у части ВМ есть свободные ресурсы. Когда все приложения одновременно требуют память, механизм не создаёт дополнительные гигабайты. Подкачка способна сохранить работоспособность, но ухудшить отклик.
ECC-память обнаруживает и исправляет определённые ошибки данных. Для бизнес-хоста это разумный выбор, однако функция должна поддерживаться всей связкой CPU, платы, BIOS и модулей. Покупки планки с надписью ECC недостаточно.
UDIMM, RDIMM и LRDIMM различаются организацией и требованиями к платформе. Их нельзя произвольно смешивать или заменять друг другом. Поколение DDR, ёмкость модулей, число установленных DIMM и их размещение сверяют с руководством сервера.
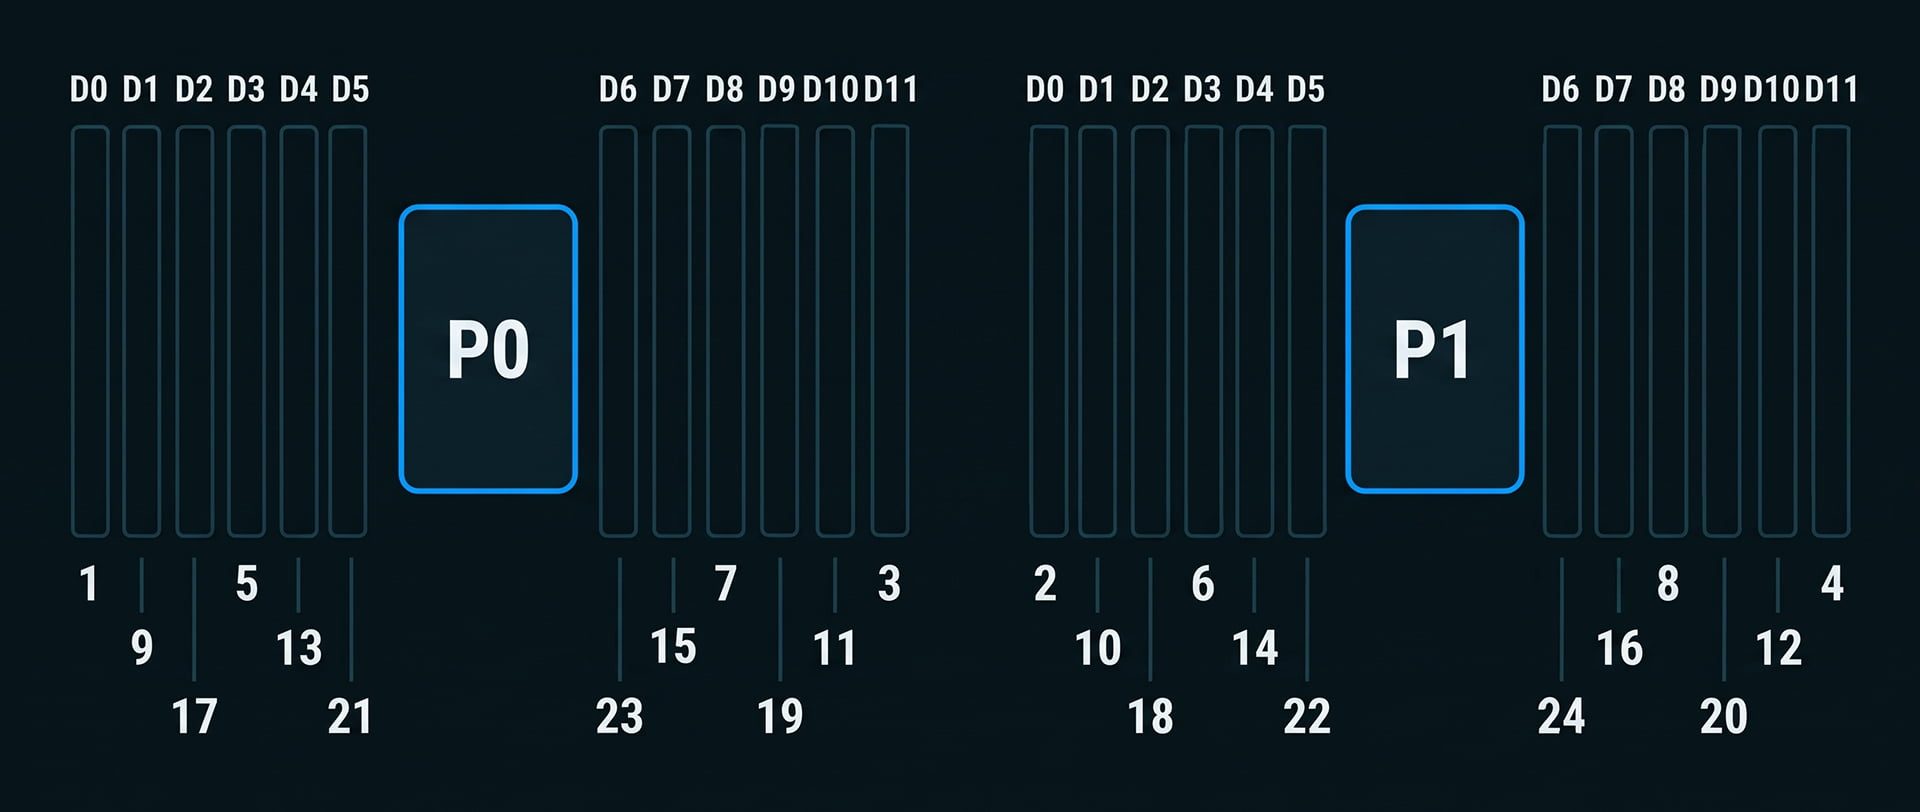
Пример порядка заполнения слотов DIMM (топология может отличаться в зависимости от модели сервера)
Каналы памяти заполняют по рекомендованной схеме. Один ёмкий модуль и несколько модулей того же суммарного объёма могут обеспечивать разную полосу доступа. Одновременно планируют расширение: свободные слоты полезны, но не ценой неоправданного ограничения текущей конфигурации. Подробнее об этом — в гайде по серверной памяти.
Накопители: NVMe, RAID и отдельный пул под виртуальные машины
Дисковая подсистема должна выполнять три разные задачи: запускать ОС хоста, обслуживать рабочие данные и хранить копии. Их не стоит объединять в один незащищённый том.
- Загрузочный том содержит ОС и служебные файлы. Зеркало помогает пережить отказ загрузочного устройства, но настройки хоста всё равно сохраняют отдельно.
- Пул ВМ хранит виртуальные диски. Его выбирают по полезной ёмкости, характеру обращений, задержкам и поведению при отказе накопителя.
- Хранилище копий располагают вне единственного рабочего пула. Для важных данных предусматривают независимую копию с отдельным доступом и подходящим сроком хранения.
NVMe снижает ограничения интерфейса и позволяет получить высокую производительность, но само название протокола не гарантирует нужного времени ответа. Несколько гостей создают смешанный поток обращений. Для базы данных важны задержки записи, для файлового сервиса — ещё и скорость передачи больших объёмов.
Кроме среднего времени ответа смотрят 95-й или 99-й перцентиль. Например, p99 показывает границу, в которую укладываются 99% измеренных задержек. Это помогает увидеть длинные ожидания, скрытые средним значением. Тест повторяют под рабочей нагрузкой, во время копирования и в допустимом аварийном режиме хранения.
Для SSD проверяют ресурс записи, устойчивую скорость после исчерпания кеша и PLP — защиту при потере питания. ИБП не заменяет PLP: питание отдельного устройства может пропасть и при исправном внешнем источнике. Различия накопителей разобраны в материале о выборе дисков для сервера.
Локальный RAID повышает доступность при определённых отказах дисков. Он не защищает от удаления файлов, шифрования данных или потери всего сервера. Для ZFS и Ceph обычно нужен прямой доступ к накопителям, а не массив, скрывающий их за аппаратным RAID-контроллером. Режим контроллера выбирают под архитектуру хранения.
Общее SAN/NAS предоставляет данные нескольким хостам. Ceph и vSAN организуют распределённое хранение, но требуют подходящей сети, совместимого оборудования и резерва на восстановление. При репликации с тремя копиями на 1 ТиБ логических данных приходится примерно 3 ТиБ под сами копии, ещё до накладных расходов и свободного места. Это не означает, что все варианты распределённого хранения всегда расходуют ёмкость одинаково.
Снимки тоже занимают место по мере изменения данных. Тонкие диски экономят ёмкость до заполнения, но не снимают обязанность контролировать свободное пространство. План расширения должен срабатывать раньше, чем одновременно остановятся несколько ВМ.
Сеть: сколько портов и какой скорости
Сеть рассчитывают по объёму обмена и времени, за которое его нужно выполнить. Для небольшого хоста с локальными дисками и умеренным пользовательским трафиком может хватить 1GbE. Общее хранилище, интенсивные миграции и короткое окно копирования могут потребовать 10GbE или 25GbE.
Допустим, за 30 минут нужно передать 200 ГиБ данных. Без сжатия это около 0,95 Гбит/с: 200 × 2³⁰ × 8 / 1 800. Для передачи 200 ГиБ за 30 минут потребуется около 0,95 Гбит/с полезной пропускной способности. С учётом протокольных расходов сети 1GbE недостаточно, чтобы гарантировать такой срок передачи. Для выполнения задачи стоит рассмотреть 10GbE и проверить скорость всей цепочки, включая накопители.
Трафик управления, гостей, хранения, миграций и копий разделяют логически, а при необходимости — физически. VLAN помогает изолировать сегменты, но не добавляет пропускную способность. Для кворума важны стабильные задержки, поэтому его обмен не должен зависеть от перегруженной линии копирования.
Два сетевых порта не гарантируют отказоустойчивость: оба могут быть подключены к одному коммутатору или находиться на одном адаптере. Проверяют весь путь, включая питание коммутаторов. Для систем хранения рассматривают поддерживаемые многопутевые подключения, а не автоматически применяют одну схему ко всем протоколам.
LACP распределяет потоки между объединёнными линиями. Один обычный поток, как правило, ограничен скоростью одного участника группы: две линии по 10 Гбит/с не превращают любое соединение в 20-гигабитное.
SR-IOV позволяет передавать гостю виртуальную функцию совместимого PCIe-устройства, например сетевого адаптера. Это может снизить программные накладные расходы. До включения проверяют драйверы, сетевые политики и поддержку миграции: поведение зависит от платформы, а не только от наличия SR-IOV в спецификации NIC.
Выбор гипервизора: VMware, Proxmox, Hyper-V и российские платформы
Короткий список платформ составляют до покупки оборудования. Затем проверяют весь комплект: сервер, сетевые и дисковые контроллеры, версии прошивок, гостевые ОС, средства копирования и управления. Факт успешной установки не равен официальной поддержке конфигурации.
| Платформа | Когда рассматривать | Поддержка и лицензии | Что проверить |
|---|---|---|---|
| VMware ESXi / vSphere | Есть инфраструктура и нужные интеграции vSphere | Коммерческие комплекты по подписке | Редакцию, совместимость оборудования и backup |
| Proxmox VE | Нужны KVM для ВМ и LXC для контейнеров, есть навыки Linux | Открытое ПО, платная подписка на поддержку и Enterprise Repository | Драйверы, хранение, восстановление и процедуры обновления |
| Hyper-V | Команда администрирует Windows Server | Роль в Windows Server, права гостей зависят от лицензирования ОС | Кластер, инструменты управления и гостевые лицензии |
| zVirt | Нужны российская платформа и поддержка разработчика | Возможности зависят от редакции и договора | Совместимость ОС, миграцию, API и интеграции backup |
| РЕД Виртуализация / РЕД ВИРТ | Нужна российская среда, в том числе в экосистеме РЕД ОС | Редакцию и сопровождение согласуют с поставщиком | Поддержку оборудования, гостей и выбранного хранилища |
KVM — механизм аппаратной виртуализации в ядре Linux, а не готовая замена всей системе управления. LXC использует контейнеры с общим ядром хостовой ОС. Контейнер и полноценная гостевая ОС решают разные задачи, поэтому их нельзя считать одинаковыми единицами при подборе платформы.
Для российских решений проверяют документацию конкретной версии. Наличие функции в одной редакции не подтверждает её в другой. Если проект требует определённой сертификации, сверяют её применимость к выбранной версии и конфигурации, а не только название продукта.
Лицензирование и риски зависимости от вендора
Виртуализация серверов меняет структуру затрат: экономия на физических машинах может сопровождаться расходами на программные права и сопровождение. Коммерческие пакеты vSphere рассчитываются по физическим ядрам с установленными минимумами на CPU. Состав комплекта, срок подписки и право на обновления проверяют в предложении поставщика.
В Proxmox VE все функции виртуализации доступны без платной подписки. Подписка предоставляет доступ к Enterprise Repository, а техническая поддержка зависит от тарифа. Например, Community не включает поддержку по заявкам. Стоимость подписки рассчитывают по числу занятых процессорных сокетов, а не по количеству ВМ.
При полном лицензировании физических ядер с учётом установленных минимумов Windows Server 2025 Standard даёт права на два Windows Server-гостя, Datacenter — на неограниченное число на лицензированном сервере. В Standard дополнительная физическая ОС Windows разрешена только для размещения и управления гостями. Для следующих гостей требуется дополнительное покрытие. Есть и лицензирование по ВМ при выполнении условий программы. Для клиентов и терминального доступа отдельно проверяют CAL и RDS CAL.
Лицензия платформы не заменяет права на гостевую Windows, СУБД или 1С. Правила переноса и работы на резервном узле тоже проверяют заранее. Старый отдельный бесплатный продукт Microsoft Hyper-V Server 2019 не стоит принимать за новую бесплатную редакцию Windows Server.
Риск зависимости от вендора снижают проверенным планом выхода: экспорт ВМ, перенос форматов дисков, замена драйверов и восстановление копии на другой платформе. Наличие пункта «импорт» в меню не заменяет тест запуска приложения после переноса.
Виртуализация с видеокартами: VDI и vGPU
VDI — виртуальные рабочие столы, обычно с отдельной гостевой ОС для пользователя. Это не то же самое, что несколько сеансов на одном терминальном сервере. Графическое ускорение востребовано в CAD, 3D-приложениях и других задачах с заметной нагрузкой на GPU. Само наличие удалённого рабочего места ещё не доказывает необходимость дорогого ускорителя.
При PCIe passthrough целую физическую карту передают одной ВМ. Гость получает эксклюзивный доступ, но устройство нельзя одновременно разделить между несколькими гостями этим способом. Обычная живая миграция такой ВМ может быть недоступна, что меняет план обслуживания и восстановления.
vGPU позволяет нескольким гостям использовать ресурсы поддерживаемого GPU через предусмотренные производителем профили. Проверяют объём видеопамяти на профиль, ограничения вычислений и кодирования, драйверы хоста и гостей, версии платформы и условия лицензии. SR-IOV описывает механизм разделения PCIe-ресурсов и сам по себе не подтверждает поддержку нужного vGPU-сценария.
Число рабочих мест нельзя получить простым делением VRAM на память одного профиля. Нужен тест одновременной работы приложений, мониторов и удалённого протокола. Для восстановления после отказа на другом узле должны быть совместимый ускоритель и свободные ресурсы. Даже поддерживаемая миграция зависит от сочетания GPU, ПО и профилей.
Поэтому сервер для ИИ не становится готовым VDI-хостом только из-за мощных карт. Совместимость выбранного сценария подтверждают до заказа, вместе с питанием, охлаждением и размещением устройств в PCIe-слотах.
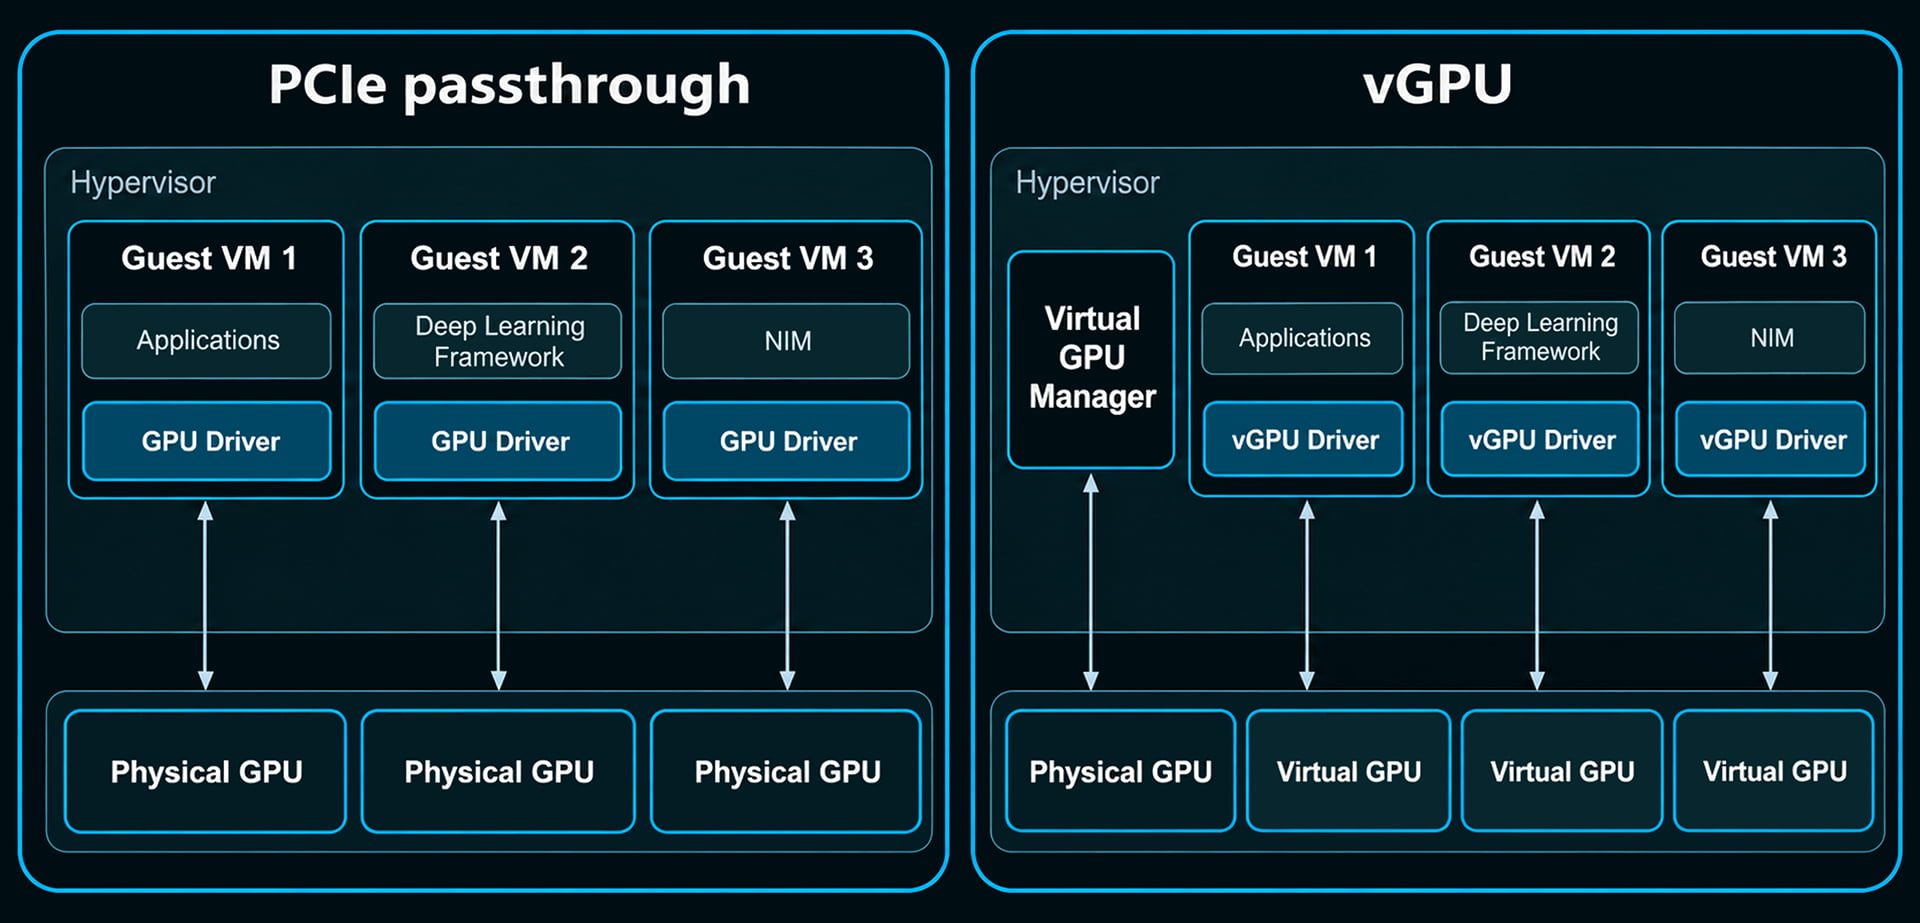
Отправная точка для выбора GPU-сервера — список приложений, число одновременных пользователей и нужный способ доступа к видеокарте. Эти данные позволяют отобрать конфигурации, для которых подтверждена поддержка passthrough или vGPU, вместо сравнения только мощности ускорителей.
Выберите GPU-сервер под свои задачи
Готовые конфигурации для инференса, машинного обучения и вычислений
Отказоустойчивость и резервное копирование
Требования к восстановлению задают два показателя. RPO — допустимая потеря данных во времени. RTO — допустимое время восстановления сервиса. Например, требование сохранить изменения не старше часа отличается от требования вернуть работу за час. Эти цели согласуют с владельцем системы, а не назначают по умолчанию.
HA, или высокая доступность, позволяет автоматически перезапустить гостя на исправном узле при подходящей архитектуре. Это не обещание нулевого простоя: обнаружение отказа, запуск ОС и восстановление приложения занимают время. Для меньшего перерыва может потребоваться отказоустойчивость самого приложения или базы данных.
Репликация переносит изменения на вторую копию, иногда с задержкой. Она может перенести и ошибочное удаление. Снапшот фиксирует состояние для отката, но обычно зависит от исходного хранилища. RAID помогает пережить определённые отказы дисков. Ни один из этих механизмов по отдельности не заменяет независимое резервное копирование.
Для БД нужна согласованная копия: штатное резервирование СУБД или поддерживаемый механизм согласования состояния приложения. Копирование открытого виртуального диска без такой процедуры нельзя автоматически считать пригодным способом восстановления базы.
Копии хранят с историей, ограничивают возможность их изменения и предусматривают отдельную площадку либо изолированный носитель. Проверка должна заканчиваться запуском восстановленного сервиса и контролем данных, а не только сообщением «задание выполнено».
Аппаратную отказоустойчивость дополняют резервируемыми БП, продуманным электропитанием и ИБП. Два БП на одной ненадёжной линии не устраняют общий риск. BMC/IPMI даёт удалённый доступ к консоли и диагностике даже при проблемах с основной ОС. Интерфейс управления изолируют от пользовательской сети и публичного интернета.
Один мощный сервер или кластер из нескольких
Один мощный хост проще обслуживать, но его ремонт останавливает все размещённые сервисы. Кластер нужен, когда стоимость такого простоя оправдывает дополнительное оборудование, хранение и сопровождение. Два купленных сервера ещё не образуют работающую схему восстановления.
| Архитектура | Преимущество | Что произойдёт при отказе хоста | Что предусмотреть |
|---|---|---|---|
| Один хост | Проще запуск и обслуживание | Сервисы ждут ремонта либо восстановления на другом оборудовании | Независимые копии, запасные компоненты и согласованный простой |
| Два узла | Возможность переноса и резервирования | Результат зависит от кворума, данных и свободной мощности | Поддерживаемую схему со свидетелем, доступ к дискам и резерв ресурсов |
| Три и более узла | Больше вариантов размещения и обслуживания | HA возможна при сохранении кворума и доступности данных | Домены отказа, резерв N+1, сеть и проверку аварийного режима |
Кворум определяет, какая часть разделившегося кластера вправе продолжать управление ресурсами. Свидетель или qdevice добавляет голос в поддерживаемой архитектуре, но не хранит вместо узлов все рабочие данные и не запускает их ВМ. Его нельзя размещать так, чтобы отказ одного из защищаемых узлов одновременно лишал систему арбитра.
Также нужна изоляция неисправного узла, или fencing, чтобы два хоста не начали независимо изменять одни данные. Для Ceph и vSAN отдельно проверяют правила размещения копий, кворум и допустимые отказы. Кворум вычислительной части не доказывает доступность хранения.
Резерв N+1 означает, что после потери одного узла оставшиеся способны принять критичные сервисы. Для памяти одинаковых хостов упрощённая проверка выглядит так:
RAM критичных гостей с запасом ≤ (N − 1) × (RAM одного узла − расходы его служб).
Вернёмся к примеру: гостям с ростом нужно 72 ГиБ. Два хоста по 64 ГиБ при условных расходах 8 ГиБ на каждый после отказа одного оставят только 56 ГиБ. Общие 128 ГиБ кластера выглядят достаточными, но проверку N+1 такая схема не проходит. Два узла по 128 ГиБ оставят 120 ГиБ на выжившем хосте и пройдут проверку по RAM — не автоматически по CPU, дискам и сети.
Проверяют и возможность разместить каждую крупную ВМ целиком на оставшемся узле. Затем тестируют запуск всех критичных сервисов и нагрузку во время восстановления хранения. Если несколько серверов, их копии и коммутатор зависят от одной линии питания, запас ядер не устранит эту общую точку отказа.
Типичные ошибки при выборе сервера
Перед заказом полезно проверить не только спецификацию, но и проект целиком:
- Производительность рассчитана по числу ВМ или vCPU без профиля одновременной нагрузки.
- Вся RAM роздана гостям, а ресурсы ОС, хранения и аварийного режима забыты.
- SSD выбран только по ёмкости и пиковой скорости без проверки задержек, ресурса записи и PLP.
- Копии лежат на единственном рабочем массиве, тест восстановления не проводился.
- Два узла названы отказоустойчивым кластером без кворума, доступных данных и резерва N+1.
- Совместимость GPU и лицензий предполагается по названию продукта, а не проверяется по версии и сценарию.
Отдельно уточняют удалённое управление, срок реакции сервиса и наличие заменяемых компонентов. Сервер для виртуализации выбирают не только на день запуска: восстановить его работу через два года должно быть так же понятно, как включить впервые.
Часто задаваемые вопросы (FAQ)
Заключение
Хороший сервер для виртуальных машин начинается с профилей нагрузки и требований к восстановлению. Расчёт памяти и ёмкости даёт нижнюю границу, а тест совместной работы подтверждает CPU, диски и сеть. Платформу и её совместимость согласуют до закупки, кластер проверяют не только в штатном режиме, но и после отказа узла.
Если после расчёта остались вопросы по совместимости, резервированию или расширению, соберите перечень ВМ, замеры нагрузки и требования RPO/RTO. С такими исходными данными проще предметно обсудить конфигурацию и избежать лишних затрат.


