Whisper локально: расшифровка аудио и видео в текст на своём ПК


Есть проект? Напишите нам
Обсудим задачу и подберём оборудование
Интервью, лекцию или запись совещания можно превратить в текст без загрузки файла в облако. Разберём, как выбрать модель, подготовить компьютер и получить TXT, SRT или VTT. Основная инструкция рассчитана на Windows 11, а отдельный пример поможет обработать целую папку записей.
Коротко: что такое Whisper и зачем запускать его у себя
OpenAI Whisper — семейство моделей распознавания речи и открытая программа для их запуска. Транскрибация аудио и видео здесь означает обработку звуковой дорожки: модель распознаёт произнесённые слова, но не читает надписи и не описывает происходящее в кадре.
Локальная программа работает на CPU или совместимом GPU. Для неё не нужен ключ облачного API. Онлайн-сервис с похожим названием и сторонняя оболочка — другие продукты: они могут отправлять запись на удалённый сервер, брать плату и иначе хранить результат.
Начать лучше с короткого знакомого фрагмента. Он покажет, хватает ли ресурсов и сколько ручных исправлений потребуется. Покупать новое оборудование до такой проверки необязательно.
Зачем запускать Whisper локально, а не через онлайн-сервис
Локальный запуск даёт контроль над файлами, настройками распознавания и очередью заданий. Обратная сторона — установка, обновления и устранение ошибок остаются на владельце ПК. Поэтому выбор зависит не только от качества текста, но и от того, кто будет поддерживать программу.
Конфиденциальность записей и работа без интернета
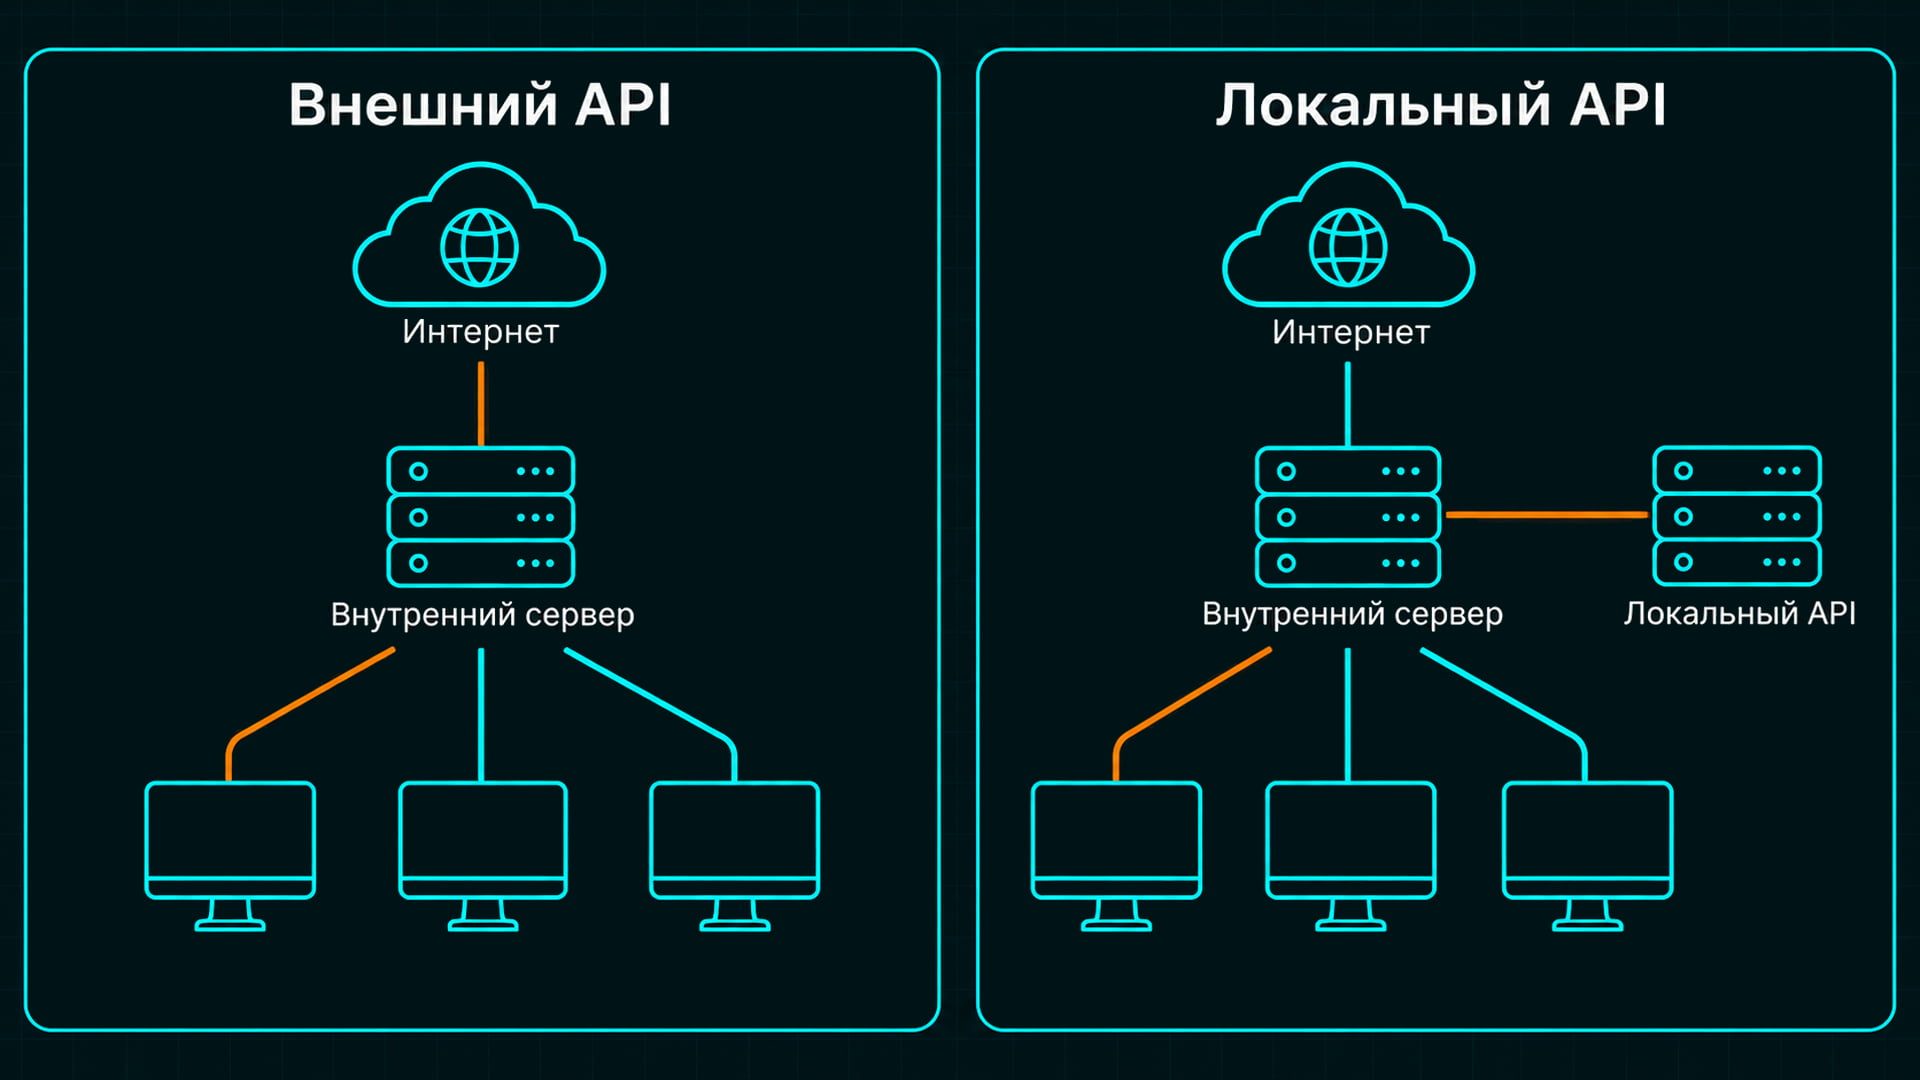
В исходной локальной реализации звук обрабатывается на компьютере. Но офлайн-режим начинается не с установки: сначала понадобятся пакеты, зависимости и веса выбранной модели. При выборе другой модели может потребоваться новая загрузка. Дополнительные средства разделения спикеров тоже используют собственные файлы.
Для проверки сначала выполни пробную обработку при доступе к сети, затем повтори её без интернета с той же моделью. Такой тест полезнее обещания «всё локально» на странице стороннего приложения. У оболочек отдельно проверь обращения к внешним сервисам, облачное резервирование и телеметрию.
Конфиденциальность записей зависит и от хранения. Папка с результатами может синхронизироваться с облачным диском, а текст — попасть в журнал терминала. Для закрытых материалов используй локальный каталог с ограниченным доступом, проверь настройки синхронизации и не сохраняй расшифровку в общих логах.
Whisper — лишь один из вариантов локальной обработки. Другие задачи разобраны в материале о том, какие модели ИИ можно развернуть на своём ПК или сервере.
Объёмы и стоимость при большом потоке записей
Расшифровка аудио в текст на собственном ПК не оплачивается по минутам в исходном открытом проекте. Но остаются затраты на электричество, оборудование, настройку и вычитку. Программа с бесплатной моделью внутри тоже может продаваться отдельно.
Для разового интервью установка иногда занимает больше усилий, чем использование готового сервиса. При регулярной работе полезнее оценивать весь процесс: загрузку файлов, распознавание, исправления, экспорт и повторную обработку после ошибки.
Сравнивай варианты на одном наборе записей. Отдельно измеряй время первого запуска с загрузкой весов и повторного запуска, когда всё уже сохранено. Не менее важный показатель — сколько времени редактор тратит на исправление часа материала. Быстрый движок невыгоден, если после него приходится заново переслушивать почти каждую фразу.
Какие модели Whisper существуют и чем отличаются
Основные размеры — tiny, base, small, medium и large. В крупном семействе есть разные версии, поэтому для повторяемого результата лучше указывать large-v3, а не полагаться на общее имя large. Ускоренный вариант large-v3-turbo в примерах ниже обозначен коротким именем turbo.
Варианты с суффиксом .en предназначены для английской речи. Для русской записи выбирай многоязычную модель Whisper без этого суффикса. Указание русского языка не превращает small.en в многоязычную модель.
Сравнение моделей Whisper: размер, VRAM и скорость
В таблице размер означает число параметров, а не объём файла на SSD. Значения VRAM — приблизительные ориентиры исходной реализации на PyTorch, а не универсальный минимум для всех движков и режимов вычислений.
| Модель | Число параметров | Ориентир VRAM | Для чего пробовать |
|---|---|---|---|
| tiny | 39 млн | Около 1 ГБ | Проверка установки, простые короткие записи |
| base | 74 млн | Около 1 ГБ | Лёгкий вариант для CPU и предварительного текста |
| small | 244 млн | Около 2 ГБ | Отправная точка для сравнения качества и нагрузки |
| medium | 769 млн | Около 5 ГБ | Повторная обработка сложной речи, если хватает ресурсов |
| large-v3 | 1,55 млрд | Около 10 ГБ | Проверка качества на сложном многоязычном материале |
| turbo | 809 млн | Около 6 ГБ | Ускоренная транскрибация при достаточной свободной памяти GPU |
Модель Whisper с большим числом параметров не обязана быстрее или точнее обработать каждую запись. Размер декодера, движок, формат вычислений и настройки тоже влияют на результат. Поэтому таблица не обещает конкретное время обработки часа русской речи.
Ориентир VRAM нельзя переносить на квантованную модель или пакет из нескольких фрагментов. Квантование уменьшает точность представления чисел и может снизить потребление памяти. Увеличение размера пакета, напротив, способно потребовать дополнительную память. Проверять нужно весь выбранный режим, а не только название модели.
Практичный порядок выбора: tiny для проверки установки, затем small как первый кандидат для своих записей. При неудовлетворительном результате сравни его с medium, large-v3 или turbo на том же фрагменте. Оцени не только пропуски слов, но и фамилии, цифры, отрицания и специальные термины.
Транскрибация сохраняет язык речи, а задача translate в исходной программе переводит речь на английский. Turbo не обучена для этого перевода. Для него выбирай другую многоязычную модель, например medium или large-v3. Перевод на произвольный язык — уже отдельный этап.
Какой компьютер нужен для Whisper
Требования определяются моделью, движком, размером задания и допустимым ожиданием. Транскрибация аудио и видео не требует серверного ускорителя только потому, что в ней используется нейросеть. Для начала подходит имеющийся компьютер, включая систему без дискретного GPU.
Ниже — ориентиры планирования, а не официальные минимальные требования. Объём RAM указан с учётом ОС и обычной работы за ПК. Фактическую потребность проверяй на своей записи.
| Нагрузка | С чего начать | Память и накопитель | Когда усиливать ПК |
|---|---|---|---|
| Короткие записи время от времени | CPU, tiny/base, затем проба small | 16 ГБ RAM как удобный ориентир. Место для среды, модели и исходников | Когда ожидание мешает работе, а качество выбранной модели устраивает |
| Ежедневные интервью и лекции | Совместимый NVIDIA RTX, сравнение small и turbo | 16–32 ГБ RAM. Для turbo ориентир около 6 ГБ свободной VRAM плюс запас | Если более крупная модель улучшает текст, но не помещается или слишком медленна |
| Многочасовой архив и очередь заказов | Замер одного задания, затем подбор GPU и очереди | От 32 ГБ RAM как отправная точка, ёмкость SSD по архиву. Для large-v3 — около 10 ГБ VRAM плюс запас | При накоплении очереди, параллельных задачах и требованиях к срокам |
Длинный файл влияет и на системную RAM: исходная программа загружает декодированный звук в память, хотя распознаёт его по окнам. Для больших архивов полезно разделять материалы на управляемые задания. Дополнительное место занимают пакеты Python, кэш загрузок, несколько моделей и промежуточные WAV.
Работа на видеокарте NVIDIA
Видеокарта ускоряет вычисления через CUDA, если GPU, драйвер и сборка PyTorch совместимы. Наличие NVIDIA в диспетчере устройств ещё не означает, что установленная библиотека умеет её использовать. Это проверяется из того же Python-окружения, где установлен Whisper.
Оцени свободную VRAM, а не только объём на коробке. Браузер, видеоредактор и другая нейросеть могут занимать её одновременно. Когда модель Whisper почти заполняет память, закрытие соседних приложений иногда полезнее переустановки программы.
Покупать NVIDIA RTX старшего класса для редких интервью необязательно. Сначала выбери модель и измерь ожидание на доступной системе. Разницу между домашним GPU, станцией и сервером разбираем в гайде по оборудованию для локального ИИ.
Если нужен новый универсальный компьютер, готовые ПК DigitalRazor можно рассматривать как основу для такой задачи. Выбирать стоит по нужному объёму памяти и остальным рабочим приложениям, а не покупать отдельную станцию ради одного интервью.
Если пробный запуск показал нехватку ресурсов, ниже можно сравнить готовые настольные ПК. Для редких записей обновление компьютера может и не понадобиться.


Найдите станцию под ваши задачи
Готовые конфигурации для работы с большими массивами данных
Работа на процессоре без видеокарты
CPU-only запуск подходит для проверки, небольших объёмов и задач без жёсткого срока. Начни с tiny или base, затем попробуй small. Более крупная модель Whisper тоже может работать на CPU при достаточной RAM, но приемлемость ожидания придётся оценивать отдельно.
В исходном CLI для такого режима явно укажи --device cpu и --fp16 False. FP16 — вычисления с пониженной точностью, которые в этом CPU-сценарии нужно заменить на FP32. Это не то же самое, что INT8 в другом движке.
Если компьютер нужен ещё и для повседневной работы, не обязательно выделять его целиком под распознавание. Можно обрабатывать очередь последовательно и ограничивать число вычислительных потоков. Оптимальное значение зависит от CPU, поэтому универсальной настройки «на все ядра» нет.
Когда нужна рабочая станция или сервер
Рабочая станция оправдана, когда распознавание идёт регулярно, одновременно работают другие тяжёлые приложения или результат нужен к определённому сроку. Сервер полезен для общей очереди нескольких сотрудников, разграничения доступа и централизованного хранения.
Перед покупкой зафиксируй объём входящих записей за день, допустимое ожидание и долю повторной обработки. Несколько GPU не складывают VRAM автоматически: стандартный запуск модели на одном устройстве не превращает две карты в один ускоритель с удвоенной памятью.
Как установить и запустить Whisper: пошагово
Основной сценарий — Windows 11 x64 и PowerShell. В примерах используются Python 3.13, openai-whisper 20250625 и PyTorch 2.10.0. Это конкретный набор версий для инструкции, а не утверждение, что другие версии несовместимы.
Первый прогон сделаем на CPU с tiny: так проще отделить ошибки установки от проблем GPU. Для NVIDIA предусмотрена отдельная сборка PyTorch и переключение устройства. Команды выполняй в одном окне PowerShell. Обратный апостроф в конце строки означает продолжение команды, после него не должно быть пробелов.
ffmpeg и Python
FFmpeg декодирует звук, включая дорожку внутри видео. Python запускает программу. Установить их через WinGet можно так:
winget install --exact --id Python.Python.3.13
winget install --exact --id Gyan.FFmpeg
Если WinGet недоступен, установи Python штатным установщиком и подготовь FFmpeg отдельно. Его папку bin добавь в пользовательский PATH — список каталогов, где Windows ищет команды. Не скачивай сборки из случайных рекламных ссылок.
После установки закрой и снова открой PowerShell. Проверь доступность инструментов:
py -3.13 --version
ffmpeg -version
Первая команда должна показать установленную версию Python, вторая — сведения о FFmpeg. Пока одна из них не работает, к распознаванию переходить рано.
Создай рабочий каталог в профиле пользователя и изолированное окружение. Оно отделит зависимости от других проектов Python:
New-Item -ItemType Directory -Force "$env:USERPROFILE\whisper-local"
Set-Location "$env:USERPROFILE\whisper-local"
py -3.13 -m venv .venv
$py = ".\.venv\Scripts\python.exe"
& $py -c "import sys; print(sys.executable)"
& $py -m pip install --upgrade pip
Путь в ответе должен вести в созданную папку .venv. Мы обращаемся к её интерпретатору напрямую, поэтому активировать окружение отдельным скриптом и менять политику выполнения PowerShell не требуется. После открытия нового терминала снова перейди в whisper-local и задай переменную $py.
Установка и первая расшифровка аудио
Выбери один источник пакета PyTorch. Для компьютера без подходящего NVIDIA GPU или первого CPU-only запуска используй:
$index = "https://download.pytorch.org/whl/cpu"Для совместимого NVIDIA GPU — сборку с CUDA 12.8. Она позволяет выполнять и CPU-команды из инструкции:
$index = "https://download.pytorch.org/whl/cu128"Выполни только подходящий вариант присваивания $index, затем установи пакеты. Если сомневаешься в поддержке GPU, начни с CPU-варианта.
& $py -m pip install "torch==2.10.0" --index-url $index
& $py -m pip install "openai-whisper==20250625"
& $py -m whisper --help
& $py -m pip check
Имя пакета — openai-whisper, а команда запуска — python -m whisper. Не заменяй название пакета на просто whisper: это не равнозначная установка.
Проверь окружение и доступность GPU:
& $py -c "import torch; print(torch.__version__)"
& $py -c "import torch; print(torch.version.cuda)"
& $py -c "import torch; print(torch.cuda.is_available())"
Для CPU-сборки отсутствие CUDA ожидаемо. В GPU-варианте True означает, что PyTorch видит доступное CUDA-устройство, но окончательная проверка — короткое распознавание. CUDA Toolkit не нужно устанавливать вслепую: у готовой сборки PyTorch есть собственные зависимости, а совместимый драйвер NVIDIA всё равно обязателен.
Создай каталоги и положи короткую русскоязычную запись под именем sample.wav в input. Это должен быть настоящий WAV, а не MP3 с изменённым расширением.
New-Item -ItemType Directory -Force input, out, models
& $py -m whisper ".\input\sample.wav" --model tiny `
  --language ru --task transcribe --device cpu --fp16 False `
  --model_dir ".\models" --output_dir ".\out" `
  --output_format txt --verbose False
При первом запуске программа скачает веса tiny в models. После успешной обработки появится out\sample.txt. Расшифровка аудио в текст на этом этапе нужна прежде всего для проверки всей цепочки: чтения файла, загрузки модели и записи результата.
Затем выбери модель Whisper для рабочих материалов. Например, замени tiny на small и сравни результат. Для GPU-запуска нужны --device cuda и --fp16 True. Turbo можно попробовать, если она помещается в свободную VRAM. Изменение имени модели приведёт к загрузке её весов, если их ещё нет в models.
Сохрани состав окружения после успешного прогона:
& $py -m pip freeze | Set-Content -Encoding utf8 requirements-lock.txtТак проще проверить состав установленных пакетов и выяснить, что изменилось после обновления. Для воспроизведения окружения также сохрани адрес источника установки PyTorch: CPU или cu128. Сам requirements-lock.txt не фиксирует этот адрес. Версии драйвера, FFmpeg и расположение весов модели тоже нужно записать отдельно.
Расшифровка видео и субтитры (SRT, VTT)
Расшифровка видео в текст выполняется через его звуковую дорожку. Положи файл video.mp4 в input и запусти тот же инструмент. Параметр all создаст доступные форматы результата за один прогон:
& $py -m whisper ".\input\video.mp4" --model tiny `
  --language ru --task transcribe --device cpu --fp16 False `
  --model_dir ".\models" --output_dir ".\out" `
  --output_format all --verbose False
В out появятся video.txt, video.srt и video.vtt, а также дополнительные машинно-читаемые файлы. TXT удобен для редактирования текста. SRT и VTT содержат таймкоды и используются для отображения реплик вместе с видео. Если нужен один формат, укажи txt, srt или vtt вместо all.
Субтитры нужно проверить в проигрывателе: ошибки возможны не только в словах, но и в границах реплик. Обычные сегментные таймкоды не равны пословной синхронизации. У исходной программы есть экспериментальная опция --word_timestamps True, однако она не отменяет проверку результата.
Если в контейнере несколько звуковых дорожек, сначала выбери нужную. Команда ниже извлекает первую аудиодорожку, переводит её в моно и сохраняет WAV с частотой 16 кГц:
ffmpeg -i ".\input\video.mp4" -map 0:a:0 -vn `
  -ac 1 -ar 16000 -c:a pcm_s16le ".\input\video-track.wav"
Для второй дорожки замени 0:a:0 на 0:a:1. Предварительное извлечение не обязательно для каждого файла, но помогает отделить выбор языка озвучки и проблемы контейнера от распознавания. Конвертация не восстановит уже потерянные слова и не улучшит запись одним изменением частоты.
| Что не работает | Что проверить | Следующий шаг |
|---|---|---|
| FFmpeg не найден | Выполняется ли ffmpeg -version в этом терминале | Исправить PATH и открыть новое окно PowerShell |
| CUDA недоступна | Сборку PyTorch, наличие GPU, драйвер и выбранное окружение | Сверить совместимость. Временно выполнить CPU-прогон |
| CUDA out of memory | Свободную VRAM и запущенные приложения | Закрыть лишние процессы, уменьшить модель или пакет в поддерживающем его движке |
| Файл не декодируется | Наличие звука, выбранную дорожку, повреждения и поддержку кодека | Проверить файл проигрывателем и попробовать извлечь WAV |
Расшифровка видео в текст не заменяет распознавание надписей на слайдах. Если лектор молча показывает таблицу, её содержимое не появится в результате. Для такой задачи нужен отдельный анализ изображения.
Как ускорить Whisper: faster-whisper, whisper.cpp, WhisperX
Сначала исключи загрузку модели из повторного замера. Затем сравни движки на одинаковом файле и настройках. Фиксируй модель, устройство, формат вычислений, число потоков, beam size и размер пакета. Время обработки без проверки текста даёт неполную картину.
| Реализация | Основная задача | Что отличается |
|---|---|---|
| Исходный Python-проект | Понятный базовый запуск и экспорт | Использует PyTorch и внешний FFmpeg |
| faster-whisper | Эффективный инференс, INT8 и обработка пакетами | Движок CTranslate2. Декодирование через PyAV, поэтому внешний FFmpeg для базового чтения не обязателен |
| whisper.cpp | Нативный запуск, в том числе на CPU, и квантованные модели | Собственные бинарники, форматы весов и параметры. Для самого запуска Python не требуется |
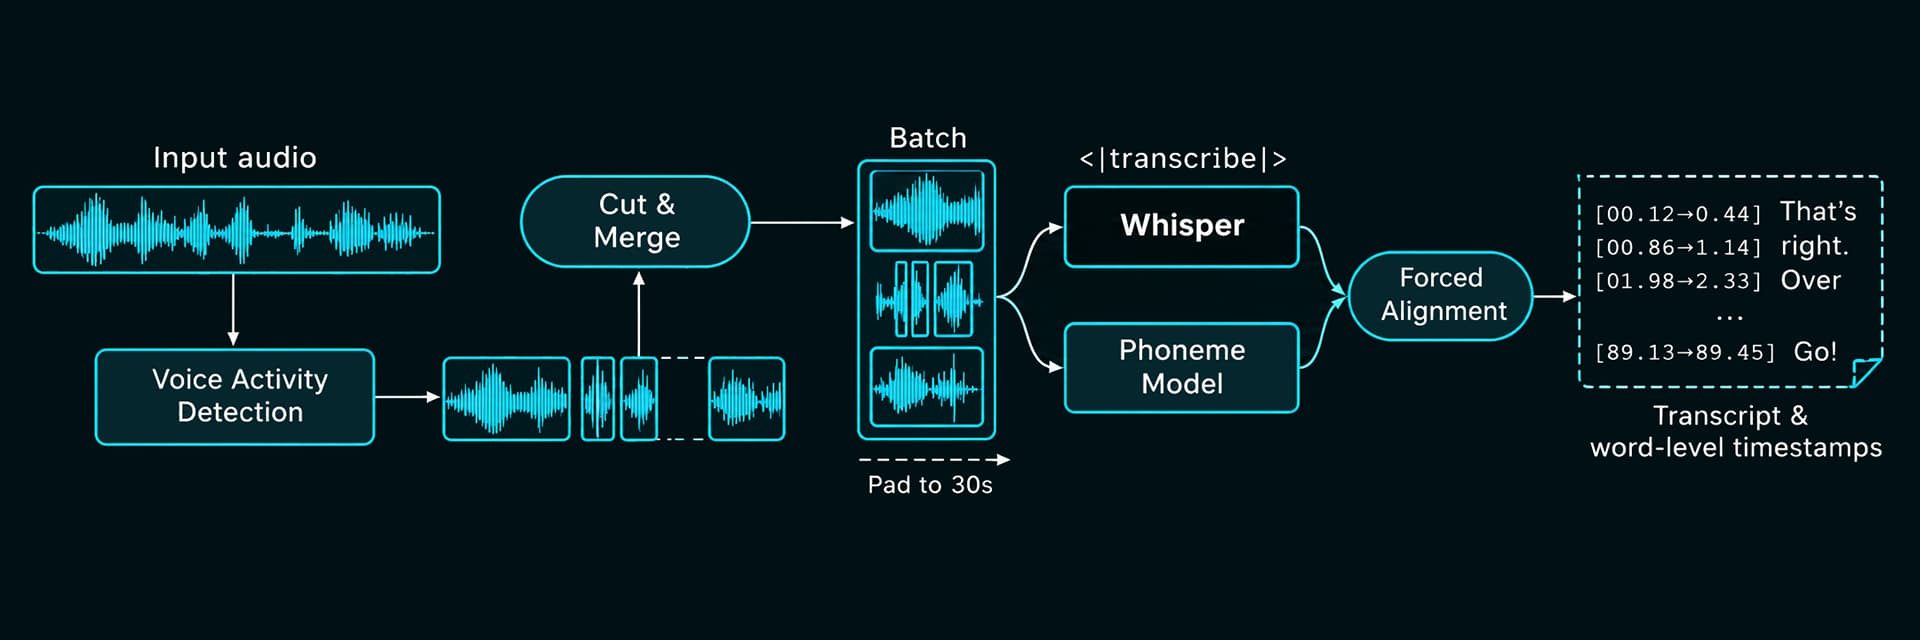
| WhisperX | Выравнивание слов по времени и дополнительная диаризация | Отдельная цепочка распознавания, VAD и дополнительных моделей |
CTranslate2 не использует GPU просто потому, что установлен CUDA-вариант PyTorch. Ему нужны совместимые библиотеки cuBLAS и cuDNN. Для NVIDIA-запуска faster-whisper в документации указаны CUDA 12 и cuDNN 9, но совместимость нужно сверять с выбранной версией CTranslate2. Для альтернативного стека лучше создать отдельное окружение.
INT8 и FP16 описывают формат вычислений. Beam size задаёт число рассматриваемых вариантов при декодировании, а batch size — размер обрабатываемого пакета. Уменьшение первого параметра может изменить качество, увеличение второго — ускорить поток ценой памяти. Очередь из ста файлов и пакет из нескольких фрагментов — не одно и то же.
Для нативного C/C++-варианта не копируй команды из Python CLI. Проверь формат модели и входного звука для конкретной сборки. WAV PCM 16 бит, моно, 16 кГц из предыдущего примера подходит для базового сценария whisper-cli. Ускорение на CPU и других устройствах зависит от доступных в сборке вычислительных модулей.
VAD определяет участки с речью и помогает исключать длинную тишину. Forced alignment сопоставляет уже распознанные слова с аудио для уточнения времени. Диаризация определяет, какие реплики относятся к одному говорящему. Это разные задачи, и последняя не встроена в обычную команду Whisper.
WhisperX может использовать отдельную модель выравнивания для языка записи и модель разделения спикеров. Для доступа к некоторым весам потребуется принять условия и получить токен Hugging Face. Проверяй возможность локальной работы всей цепочки. Метка «Спикер 1» не означает, что программа узнала имя человека, а одновременная речь остаётся сложным случаем.
Точность на русском языке и что делать с ошибками
Точность на русском языке зависит от записи: чистая речь одного человека и совещание с перебиваниями — разные задачи. Редкие фамилии, сокращения, адреса и суммы требуют отдельной проверки. Грамматически гладкий текст тоже может содержать смысловую ошибку.
Для сравнения выбери несколько фрагментов с типичными трудностями. Подготовь эталон вручную, затем проверь одну модель Whisper и альтернативный вариант. Оцени пропуски, добавленные слова и смысловые замены. Пунктуацию сравнивай отдельно, чтобы она не скрывала ошибки распознавания.
Если работа связана преимущественно с русской речью, в такое сравнение можно включить GigaAM. Это другая модельная линейка, а не режим Whisper. Заявленное преимущество на чужом наборе записей не доказывает, что она лучше справится с конкретными интервью или профессиональной лексикой.
Параметр --language ru фиксирует язык и полезен, когда запись точно русскоязычная. Для смешанной речи не назначай его автоматически. Короткий --initial_prompt может подсказать термины и написание имён, но не обучает модель и не гарантирует их правильного распознавания.
Галлюцинации, повторы и пропуски: причины и лечение
Галлюцинации модели — слова или фразы, которых не было в звуке. Они могут появляться на тишине, музыке, шуме и плохо различимой речи. Уверенный тон расшифровки ничего не говорит о достоверности такого фрагмента.
Порядок исправления лучше строить от исходника, а не от случайного перебора параметров:
- Проверь, существует ли нужная речь в выбранной дорожке и нет ли обрезанного начала или пропавшего канала.
- Для длинных пауз попробуй VAD в поддерживающем его инструменте. После этого проверь, не исчезла ли тихая речь.
- Повторяющийся фрагмент обработай отдельно. В исходной программе можно сравнить результат с
--condition_on_previous_text False, но связность соседних сегментов при этом может ухудшиться. - Сложные имена, цифры и отрицания сверяй со звуком. Их нельзя надёжно исправить одним последующим «улучшением текста» языковой моделью.
При нарезке записи сохраняй исходные временные смещения. Иначе текст отдельных частей будет правильным, но таймкоды начнутся с нуля и не совпадут с полным видео. Не режь посреди слова и не удаляй паузы без учёта их длительности, если нужен синхронизированный результат.
Пакетная обработка большого количества записей
Пакетная обработка для архива начинается с надёжной очереди. Нужно различать законченные и оборванные задания, не перезаписывать одноимённые результаты и не останавливать всю папку из-за одного повреждённого файла.
При постоянной нагрузке важно сравнивать системы не только по мощности отдельной видеокарты, но и по тому, сколько записей они успевают обработать за рабочий день.

RS24-32-256

RS32-64-256

RS32-48-512
Пример ниже обрабатывает файлы непосредственно из input, без вложенных папок. Модель загружается один раз. Результаты каждого задания сохраняются в отдельный каталог с полным именем исходного файла, включая расширение. Поэтому запись meeting.wav не смешается с meeting.mp4.
Сохрани код в batch_transcribe.py рядом с папками input и models. Для первого теста оставь tiny. После проверки замени MODEL на выбранный вариант. Скрипт использует GPU, если он доступен этому окружению, иначе CPU.
from pathlib import Path
from hashlib import sha256
import gc
import json
import torch
import whisper
from whisper.utils import get_writer

ROOT = Path(__file__).resolve().parent
SOURCE = ROOT / "input"
TARGET = ROOT / "out-batch"
MODEL = "tiny"
FORMATS = ("txt", "srt", "vtt")
EXTENSIONS = {".wav", ".mp3", ".m4a", ".flac",
              ".mp4", ".mkv", ".webm", ".ogg"}

if not SOURCE.is_dir():
    raise SystemExit("Create the input folder first.")
files = sorted(p for p in SOURCE.iterdir()
               if p.is_file() and p.suffix.lower() in EXTENSIONS)
if not files:
    raise SystemExit("No supported input files.")
TARGET.mkdir(exist_ok=True)
device = "cuda" if torch.cuda.is_available() else "cpu"
options = dict(language="ru", task="transcribe",
               fp16=device == "cuda", verbose=None)
model = whisper.load_model(
    MODEL, device=device, download_root=str(ROOT / "models")
)

def log(job_id: str, status: str) -> None:
    with (TARGET / "jobs.log").open("a", encoding="utf-8") as f:
        f.write(f"{job_id}\t{status}\n")

for path in files:
    result = None
    job_id = sha256(path.name.encode("utf-8")).hexdigest()[:16]
    try:
        stat = path.stat()
        state = json.dumps(
            [stat.st_size, stat.st_mtime_ns, MODEL, options,
             whisper.__version__, torch.__version__],
            sort_keys=True,
        )
        folder = TARGET / path.name
        folder.mkdir(exist_ok=True)
        marker = folder / ".done"
        outputs = [folder / f"result.{ext}" for ext in FORMATS]
        if (marker.exists() and marker.read_text(encoding="utf-8") == state
                and all(p.exists() for p in outputs)):
            log(job_id, "SKIP")
            continue
        marker.unlink(missing_ok=True)
        result = model.transcribe(str(path), **options)
        for ext in FORMATS:
            get_writer(ext, str(folder))(result, "result.wav")
        marker.write_text(state, encoding="utf-8")
        log(job_id, "OK")
    except Exception as error:
        log(job_id, type(error).__name__)
    finally:
        result = None
        gc.collect()
        if device == "cuda":
            torch.cuda.empty_cache()
Запусти его из рабочего каталога:
.\.venv\Scripts\python.exe .\batch_transcribe.pyВ out-batch появятся отдельные папки с result.txt, result.srt и result.vtt. Отметка .done создаётся только после сохранения всех трёх файлов. При повторном запуске учитываются размер и время изменения исходника, модель, настройки и версии библиотек. Для принудительной повторной обработки удали отметку соответствующего задания.
Журнал содержит идентификатор задания и статус, а не текст речи. Ошибка одного файла записывается, после чего очередь продолжается. Повторяющиеся ошибки нехватки памяти — повод остановить обработку и уменьшить модель, а не бесконечно перезапускать ту же очередь. Отметка OK подтверждает завершение программы, но не правильность всех слов.
Для производственного потока добавляют контроль свободного места, ограничение длины задания, права доступа и проверку результата. Параллельные процессы могут конкурировать за VRAM и CPU. Распределять очередь между несколькими GPU нужно отдельно, а не ожидать автоматического линейного ускорения.
Если транскрибация аудио и видео стала общей задачей отдела, полезно сначала определить, когда нужен локальный сервер. Он должен решать проблему общей очереди и доступа, а не просто заменять работающий настольный ПК более дорогой системой.
Выберите GPU-сервер для нейросетей
Готовые решения для работы с большими массивами данных
Когда лучше выбрать готовый сервис вместо локального запуска
Готовый сервис разумен, когда важнее быстро получить результат, чем управлять окружением. Например, для разового интервью, совместной редакторской работы или процесса, которому нужны встроенные роли пользователей, поиск и экспорт в корпоративную систему.
Перед загрузкой закрытых материалов проверь правила хранения, удаления и использования данных. Конфиденциальность записей не определяется одним словом «корпоративный» в описании сервиса. Уточни, куда передаются файлы и кто получает доступ к тексту.
Расшифровка видео в текст через сервис удобна, если локально не удаётся поддерживать нужную очередь. Но сравнивай одинаковые функции: простой TXT и готовый результат с разделением спикеров, таймкодами и редактором — не одна услуга. При переходе между вариантами считай и время ручной работы.
Часто задаваемые вопросы (FAQ)
Заключение
Запускать Whisper на своём компьютере стоит с короткой записи и небольшой модели. Проверь текст, затем сравни качество и время с более крупным вариантом. Расшифровка аудио в текст должна экономить время с учётом вычитки, а не только быстро завершаться в терминале.
Для индивидуальной работы начни с имеющегося ПК. Когда транскрибация аудио и видео становится постоянной задачей организации, требования к общей очереди, памяти и срокам можно использовать для подбора GPU-системы для инференса. Это предметный выбор оборудования под нагрузку, а не обязательный шаг для каждого пользователя.