
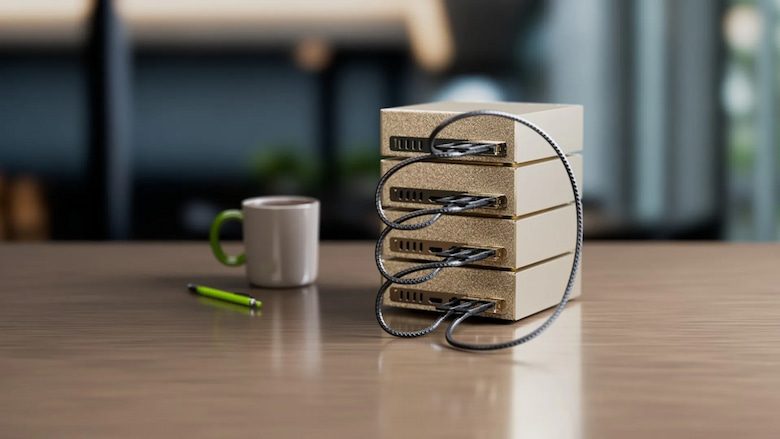
NVIDIA собрала настольный суперкомпьютер из четырёх DGX Spark с 512 ГБ памяти


Есть проект? Напишите нам
Обсудим задачу и подберём оборудование
NVIDIA представила DGX Spark HPC Developer Kit — компактный суперкомпьютер из четырёх мини-ПК, который можно разместить прямо на рабочем столе. Система получила 512 ГБ суммарной памяти и позволяет локально запускать ИИ-модели размером до 700 млрд параметров. Но главное её назначение — научные вычисления, для которых раньше приходилось арендовать серверы или ждать доступа к большому кластеру.
Краткое содержание
- DGX Spark HPC Developer Kit объединяет четыре мини-ПК на чипах GB10 Grace Blackwell;
- кластер располагает 512 ГБ суммарной памяти и 16 ТБ накопителей NVMe;
- четыре устройства соединены кольцом через NVIDIA ConnectX-7 без отдельного сетевого коммутатора;
- система поддерживает запуск моделей до 700 млрд параметров с квантованием NVFP4;
- разработчики смогут использовать инструменты NVIDIA HPC SDK для научного моделирования;
- начать работу можно с одного DGX Spark на 128 ГБ памяти, а затем наращивать количество узлов.
Четыре мини-ПК вместо огромной серверной стойки
Новинку представили на конференции Supercomputing 2026 (SC26) в Чикаго. NVIDIA предлагает исследователям, учёным и разработчикам небольшую вычислительную лабораторию, которую не нужно размещать в отдельном дата-центре.
В основе DGX Spark HPC Developer Kit лежат четыре одинаковых компьютера с суперчипами GB10 Grace Blackwell. Каждый оснащён 20-ядерным процессором Arm, графикой Blackwell и 128 ГБ единой памяти LPDDR5X. Память доступна процессору и GPU в рамках общей когерентной системы, а её пропускная способность достигает 273 ГБ/с.
Графический ускоритель содержит 6144 ядра CUDA и тензорные ядра пятого поколения. NVIDIA заявляет до 1 петафлопса вычислительной производительности FP4 с использованием разреженности данных.
Четыре таких устройства обеспечивают:
- 80 процессорных ядер Arm;
- 24 576 ядер CUDA;
- 512 ГБ суммарной памяти LPDDR5X;
- 16 ТБ накопителей NVMe;
- высокоскоростную связь через NVIDIA ConnectX-7.
При этом все устройства соединяются напрямую по кольцевой схеме: каждый компьютер связан с двумя соседними. Такая топология позволяет обойтись без отдельного сетевого коммутатора.
Конечно, это не означает, что четыре Spark автоматически превращаются в одну видеокарту с 512 ГБ памяти. Для использования всех ресурсов потребуется программное обеспечение, которое умеет распределять модель и вычисления между узлами.
Даже модели на 700 миллиардов параметров помещаются
Одна из самых интересных возможностей DGX Spark HPC — локальный запуск крупных языковых моделей.
По заявлению NVIDIA, четыре устройства позволяют развёртывать модели размером до 700 млрд параметров при использовании формата NVFP4. В качестве примера компания приводит DeepSeek V4.1.
Это становится возможным благодаря распределению весов модели между несколькими устройствами и квантованию, снижающему требования к памяти.
Впрочем, поддержка модели такого размера ещё не означает, что кластер сможет быстро обучать её с нуля. NVIDIA говорит прежде всего о развёртывании и выполнении вычислений. Реальная скорость зависит от архитектуры модели, длины контекста, программного обеспечения и интенсивности обмена данными между устройствами.
Для исследовательской лаборатории даже возможность локального запуска такой модели может оказаться полезной. Особенно когда данные нельзя передавать сторонним облачным провайдерам.
Наука тоже переезжает на рабочий стол
Несмотря на акцент на искусственном интеллекте, NVIDIA позиционирует новый комплект прежде всего как платформу для высокопроизводительных вычислений — HPC.
Компания готовит руководство по развёртыванию NVIDIA HPC SDK, включающего компиляторы C, C++ и Fortran с поддержкой GPU, библиотеки и инструменты MPI для распределённых вычислений.
Среди заявленных и продемонстрированных сценариев:
- LAMMPS и Kokkos — моделирование материалов;
- NAMD и GROMACS — молекулярная динамика;
- OpenFOAM — моделирование движения жидкостей и газов;
- WRF — прогнозирование погоды;
- OpenFold3 и Boltz-2 — исследования молекулярных структур и взаимодействий белков.
Такие инструменты используют в материаловедении, биохимии, аэродинамике и других научных областях.
Суть идеи NVIDIA не в том, чтобы полностью заменить крупные суперкомпьютеры четырьмя маленькими коробками. Разработчики смогут локально создавать и отлаживать программы, проверять обмен данными между узлами и проводить небольшие эксперименты, прежде чем переносить тяжёлые вычисления на большие кластеры.
Учёные уже используют одиночные Spark
NVIDIA привела несколько примеров того, как компактные системы помогают исследовательским командам.
В Калифорнийском университете в Беркли лаборатория Rubin Lab использует DGX Spark вместе с моделью Evo 2 для прогнозирования свойств бактерий по геномным последовательностям. По данным NVIDIA, отказ от ожидания 11-часовой очереди к общему кластеру позволил получать результаты в 15 раз быстрее. Речь именно об общем времени получения результата с учётом очереди, а не о пятнадцатикратном ускорении вычислений.
Другая команда из того же университета использовала одиночный Spark для LoRA-дообучения модели Nemotron 3 Super 120B-A12B под задачи химического машинного обучения.
А компания CYRAN AI применяет такую систему для обработки спутниковых изображений JPEG 2000.
Все эти примеры объединяет одна идея: не каждый исследовательский эксперимент требует доступа к дорогостоящей серверной инфраструктуре.
А обязательно начинать сразу с четырёх компьютеров?
Вовсе нет. И для большинства компаний разумнее сначала проверить свои задачи на одном устройстве.
В нашем ассортименте уже представлен NVIDIA DGX Spark со 128 ГБ единой памяти и суперчипом GB10 Grace Blackwell. Такая система подходит для локального запуска LLM, прототипирования ИИ-приложений, работы с агентами и дообучения моделей под корпоративные данные.
По спецификациям NVIDIA, один DGX Spark поддерживает инференс моделей до 200 млрд параметров и дообучение моделей до 70 млрд параметров при подходящих настройках и форматах хранения.
Если со временем одного устройства окажется недостаточно, можно расширить инфраструктуру:
| Конфигурация | Суммарная память | Сценарий |
|---|---|---|
| 1 × DGX Spark | 128 ГБ | Локальные LLM и разработка |
| 2 × DGX Spark | 256 ГБ | Более крупные модели |
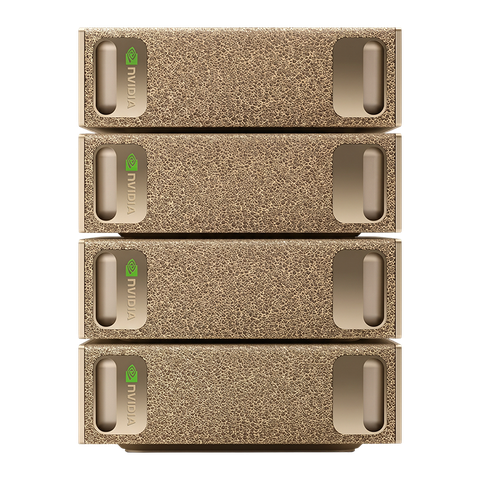
| 4 × DGX Spark | 512 ГБ | Распределённые вычисления |
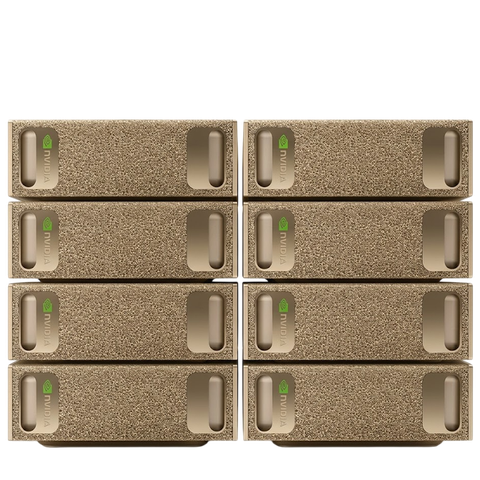
| 8 × DGX Spark | 1024 ГБ | Масштабируемый ИИ-кластер |
В DigitalRazor доступны конфигурации от одного до восьми DGX Spark. При этом восьмиузловая система — это уже отдельный проект с сетевым коммутатором и настройкой распределённых вычислений, а не стандартный четырёхузловой комплект NVIDIA.
Возможности масштабирования зависят от программного стека. С увеличением числа устройств возрастает и нагрузка на межузловую сеть, поэтому удвоение количества Spark не гарантирует удвоения производительности.
Мы уже подробно разбирали особенности таких подключений в статье «Как DGX Spark собирается в кластер».
Суперкомпьютеры становятся доступнее. Но не заменяют друг друга
DGX Spark HPC Developer Kit показывает любопытное направление развития вычислительной техники: задачи, для которых раньше требовался отдельный сервер, всё чаще можно выполнять на компактном оборудовании непосредственно в лаборатории или офисе.
Но полноценный GPU-сервер пока рано отправлять на пенсию. При работе с огромными датасетами, масштабном обучении моделей и вычислениях с высокой точностью стоечные системы с профессиональными ускорителями сохраняют серьёзные преимущества.
Поэтому ключевой вопрос не в том, сколько DGX Spark удастся поставить рядом, а в том, какие задачи действительно нужно решать.
Для начала может хватить одного компактного компьютера с 128 ГБ памяти. Если проект вырастет, к нему можно добавить второй, четвёртый и последующие узлы.
А определить необходимый объём памяти, оценить эффективность масштабирования и подобрать подходящую конфигурацию помогут инженеры DigitalRazor. Все доступные варианты представлены на странице DGX Spark для локального ИИ.


