
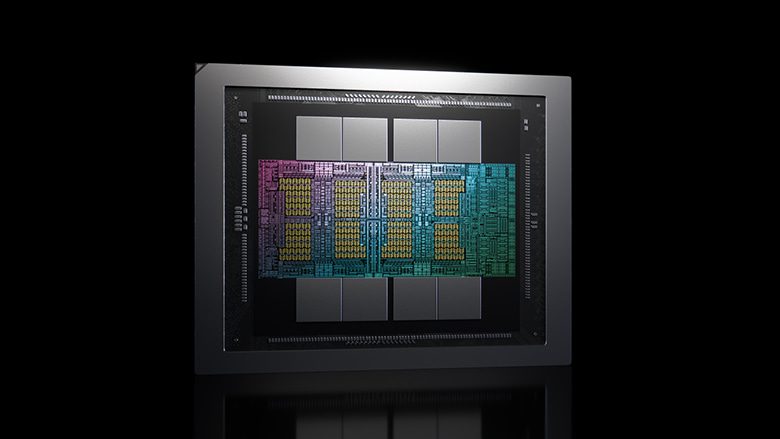
NVIDIA представила Rubin HPC: более 50 тысяч CUDA-ядер и NVLink 7


Подберём сервер под задачи
Ответьте на несколько вопросов — подготовим предложение
NVIDIA анонсировала Rubin HPC — новый графический ускоритель для суперкомпьютеров, научного моделирования и инженерных расчётов. На одном GPU разместят более 50 тысяч CUDA-ядер, а для обмена данными между ускорителями используют NVLink седьмого поколения. Новинка должна ускорить вычисления в климатологии, геномике и промышленности, но появится только в 2028 году.
Краткое содержание
- Rubin HPC получит более 50 000 CUDA-ядер — свыше чем в 2,4 раза больше, чем у B300;
- технология NVLink 7 обеспечит связь между ускорителями, но её пропускную способность пока не раскрыли;
- специальные аппаратные механизмы ускорят обработку разреженных данных;
- производительность FP64, объём видеопамяти и энергопотребление остаются неизвестными;
- выпуск Rubin HPC намечен на 2028 год.
Более 50 тысяч CUDA-ядер на одном GPU
NVIDIA представила Rubin HPC на конференции Supercomputing 2026 (SC26). В отличие от обычных ускорителей Rubin, рассчитанных преимущественно на задачи искусственного интеллекта, новая модель ориентирована на высокопроизводительные вычисления — HPC.
Главная цифра анонса — более 50 тысяч CUDA-ядер в одном графическом процессоре. Для сравнения, NVIDIA B300 на архитектуре Blackwell Ultra содержит 20 480 ядер, а полностью разблокированный GB202 — 24 576. Получается, что Rubin HPC превзойдёт B300 по количеству CUDA-ядер более чем в 2,4 раза.
Как NVIDIA собирается разместить столько вычислительных блоков, пока неизвестно. Компания не раскрыла ни количество потоковых мультипроцессоров (SM), ни компоновку кристаллов. Возможно, инженеры используют многокристальную архитектуру, но официального подтверждения этому нет.
Однако рекордное количество CUDA-ядер — только половина истории. В научных вычислениях важно не просто быстро считать, но и своевременно доставлять данные к вычислительным блокам.
Зачем понадобились NVLink 7 и ускорение разреженных данных
Представим суперкомпьютер, который моделирует движение воздушных масс или рассчитывает прочность сложной конструкции. Ему приходится обрабатывать огромные массивы информации, постоянно обращаясь к разным участкам памяти.
Проблема в том, что данные далеко не всегда расположены последовательно. Например, при работе с разреженными матрицами ускоритель может тратить значительную часть времени на ожидание информации, а не на сами вычисления.
В Rubin HPC NVIDIA предусмотрела аппаратные механизмы для ускорения подобных операций. Они должны эффективнее подавать данные CUDA-ядрам и сокращать простои при выполнении научных расчётов.
Второе важное изменение — NVLink седьмого поколения.
Для сравнения:
- NVLink 5 в Blackwell и Blackwell Ultra — до 1,8 ТБ/с на GPU;
- NVLink 6 в стандартных Rubin — до 3,6 ТБ/с на GPU;
- NVLink 7 в Rubin HPC — пропускная способность пока не объявлена.
Быстрая связь особенно важна для задач, распределённых между несколькими GPU. Например, при моделировании сложных физических процессов ускорителям приходится постоянно обмениваться промежуточными результатами. Если связь не справляется с нагрузкой, дополнительные вычислительные блоки не обеспечат пропорционального прироста скорости.
Главная интрига — производительность FP64
Пожалуй, самый интересный параметр Rubin HPC NVIDIA пока оставила за кадром.
Речь о FP64 — вычислениях с двойной точностью. Они необходимы во многих научных и инженерных приложениях, где важна точность численных результатов.
Современные ускорители NVIDIA далеко не одинаково справляются с такими задачами. Например, B200 обеспечивает около 37 ТФЛОПС нативной производительности FP64, тогда как B300 — всего около 1,2 ТФЛОПС.
Причина в специализации. Blackwell Ultra в первую очередь создавали для ИИ, где гораздо важнее производительность в форматах с пониженной точностью.
Стандартный Rubin должен обеспечивать 33 ТФЛОПС нативного FP64. Для операций DGEMM NVIDIA также заявляет до 200 ТФЛОПС при использовании программной эмуляции на Tensor Cores. Но Rubin HPC — отдельная конфигурация, и переносить на неё эти показатели пока нельзя.
Поэтому делать вывод, что 50 тысяч CUDA-ядер автоматически обеспечат рекордную скорость научных расчётов, преждевременно. Для полноценного сравнения нужны характеристики FP64, памяти и результаты тестирования.
А что можно использовать уже сейчас?
Пока NVIDIA готовит Rubin HPC к выходу в 2028 году, для крупных ИИ-проектов уже доступны серверные платформы Blackwell Ultra.
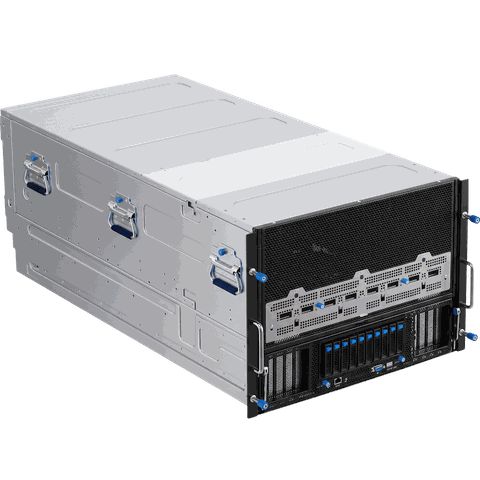
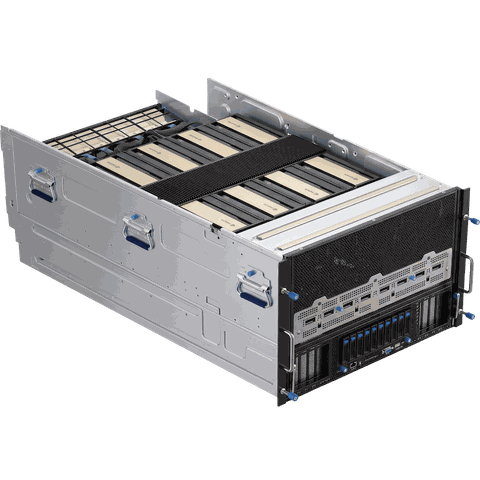
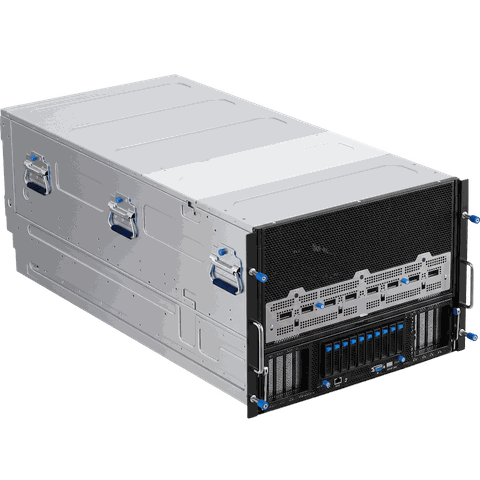
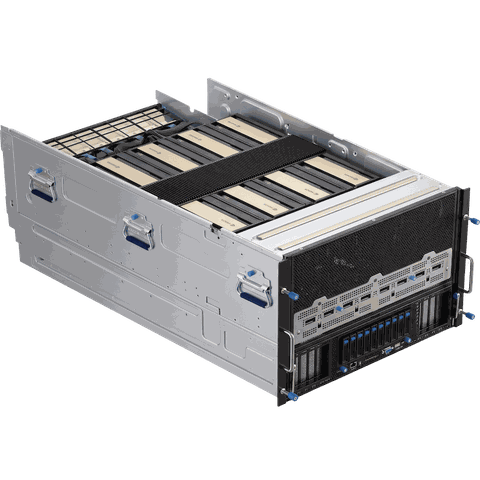
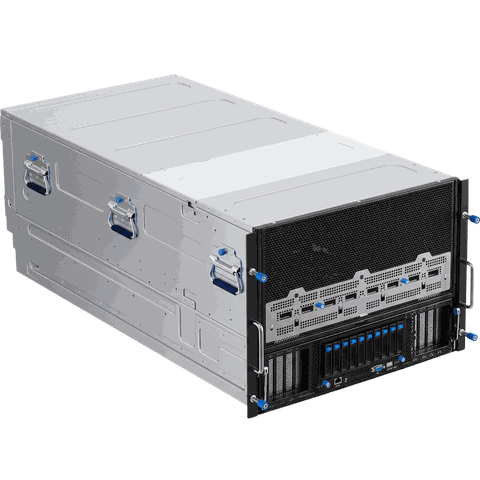
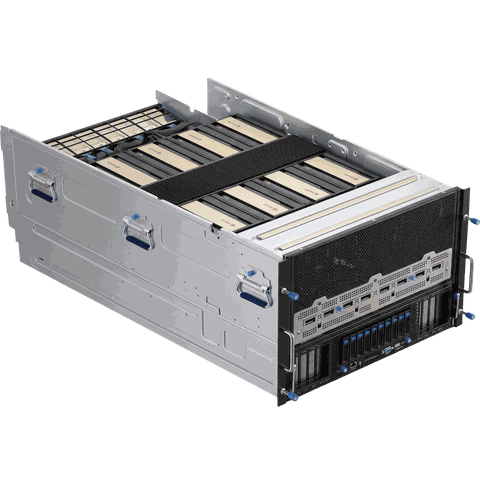
Например, в нашем каталоге представлен NVIDIA HGX B300 — сервер с восемью ускорителями B300 SXM, объединёнными посредством NVLink 5 и NVSwitch.
Каждый GPU располагает 288 ГБ памяти HBM3e, а суммарный объём установленной видеопамяти системы составляет 2 304 ГБ. Обмен между ускорителями достигает 1,8 ТБ/с на GPU.
Такая конфигурация предназначена прежде всего для обучения и дообучения крупных нейросетей, инференса LLM и VLM, а также построения многосерверных вычислительных систем. При этом NVLink и NVSwitch не превращают память восьми GPU в единый автоматически доступный массив — распределением данных управляет программная среда.
Важно различать назначение платформ. HGX B300 ориентирована преимущественно на ИИ-нагрузки, а будущий Rubin HPC NVIDIA разрабатывает специально для научных вычислений. Поэтому при выборе оборудования нужно учитывать не только количество GPU и объём памяти, но и точность вычислений, характер обмена данными и требования используемого ПО.
Когда выйдет Rubin HPC
NVIDIA планирует выпустить ускоритель в 2028 году. Точную дату, объём памяти, энергопотребление и показатели производительности пока не называют.
Компания также намерена развивать библиотеки CUDA-X, чтобы исследователи и ИИ-агенты могли использовать оптимизированные алгоритмы для научных расчётов.
Идея следующая: ИИ предлагает новую конструкцию, материал или молекулу, запускает моделирование, анализирует результат и корректирует следующую гипотезу. Чем быстрее работает вычислительная инфраструктура, тем больше вариантов удастся проверить за то же время.
Впрочем, реальный потенциал Rubin HPC станет понятен только после публикации технических характеристик и независимых тестов. Пока NVIDIA показала направление развития своих суперкомпьютерных ускорителей, но не раскрыла достаточно данных, чтобы оценить обещанный прирост производительности.


